十一月三号上午九点四十,Ollama 发了 0.40.14。发布说明里最长的几条都不像模型新闻:ollama launch claude 现在会把模型的输出上限套用到 Claude Code 上;claude 的云端模型不再被 128k 的默认上限卡住;ollama launch codex 会先验证 ChatGPT 路由,路由不可用就报一个清楚的错。
把这些句子连起来看,意思变了。Ollama 过去是「在你机器上跑模型的东西」,现在它在给你启动别人家的编码代理,并且替它们挑模型、配路由、管上限。我在一台只有 RX 580 的 Windows 机器上装了它,从下载体积一路测到 Claude Code 接上去为止。
文档写 5 个集成,二进制里躺着 18 个
官方 CLI 文档的「Launch integrations」只列了五个:OpenCode、Claude Code、Codex、VS Code、Droid。而 ollama launch --help 在这台机器上吐出来的清单是这样的:claude、chatgpt、hermes、openclaw、opencode、codex、hermes-desktop、copilot、omp、droid、dsh(DeepSeek Harness)、kimi、muse、pi、pool、cline、qwen、vscode。十八个,文档只写了五个。
它替这些工具做的事,本质上是三条环境变量:ANTHROPIC_AUTH_TOKEN=ollama、ANTHROPIC_API_KEY 留空、ANTHROPIC_BASE_URL 指向本地的 11434。手写也能配,launch 只是把这套配置包了一层,再拉起对方的可执行文件。所以真正值得看的是它本地那个 Anthropic 兼容层到底实现了多少。
按官方兼容性文档,/v1/messages 支持消息、流式、系统提示、多轮、图片(base64)、工具调用与工具结果、thinking,以及 model、max_tokens、system、temperature、top_p、top_k、stop_sequences、tools、thinking、output_config.effort 这些请求字段。不支持的清单更有信息量:count_tokens 端点、tool_choice(强制指定或关掉某个工具)、metadata 里的 user_id、提示缓存(cache_control)、批处理 API、引用块、PDF 文档块,以及流式过程中以事件形式返回错误。
其中提示缓存这一条,是拿它当日常编码代理用的人最先会撞上的墙。Claude Code 的长会话之所以能用,很大一部分靠前缀缓存把重复的上下文压成便宜 token;这条链在 Ollama 这边是断的,意味着每一轮都要把整段上下文重新算一遍 KV。1.7B 的模型你感觉不到,30B 以上的模型上这就是成倍的钱和时间。
装它卡在哪:1.5 GB 下载,2.1 GB 落地,其中 2 GB 是 NVIDIA 的库
Windows 免安装包 ollama-windows-amd64.zip 是 1527.7 MB。我这台机器上它解压用了 33.5 秒,落地 2.1 GB。拆开看,ollama.exe 本体只有 39 MB,剩下的是运行时:cuda_v12 占 1.1 GB,cuda_v13 占 903 MB,vulkan 占 41 MB,没有任何一个 rocm、hip 或 amdgpu 文件。
也就是说,一张 AMD 卡的用户,下载的这一千五百兆里有两千兆是给 NVIDIA 准备的。官方另外提供了 245 MB 的 ollama-windows-amd64-rocm.zip,但 RX 580 属于 gfx803,ROCm 早就不认这代卡了,换包也救不回来。
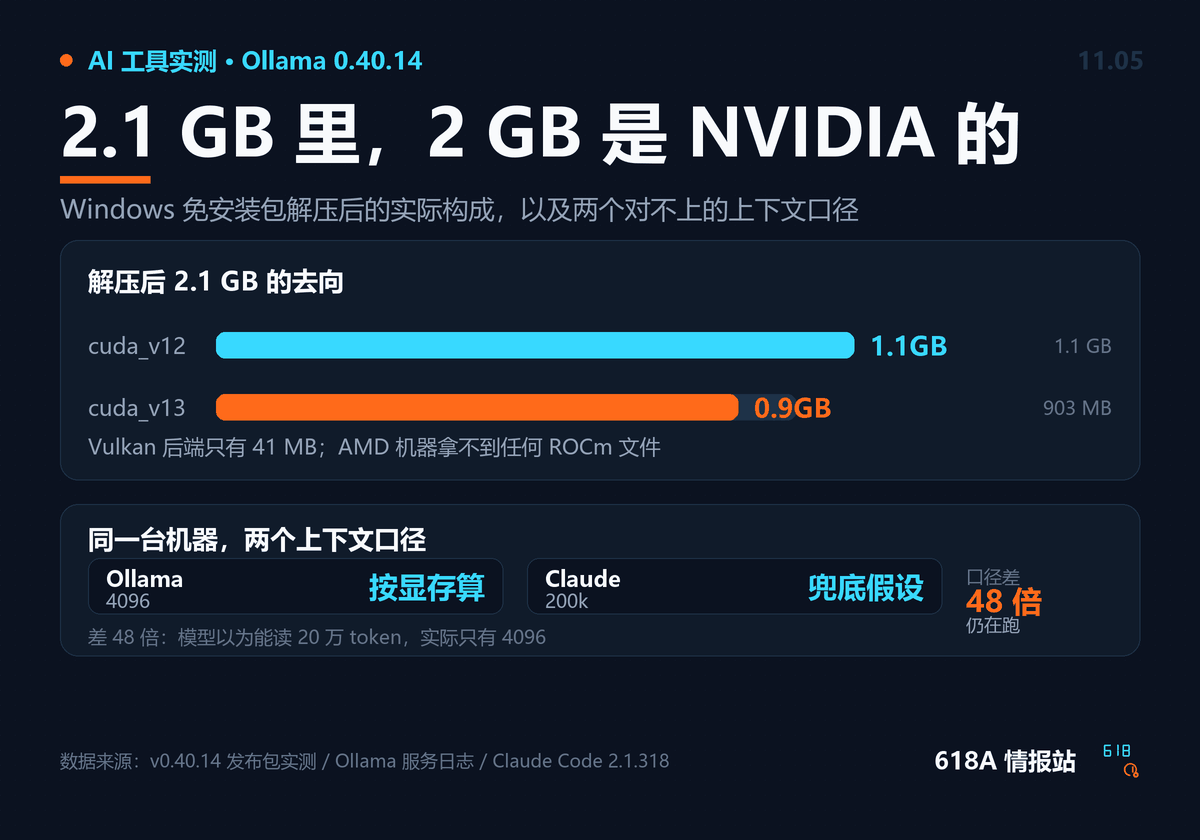
真正让这张卡跑起来的反而是那 41 MB 的 Vulkan。服务启动时的日志很说明问题:先是 CUDA 方向探测直接崩掉,llama-server --list-devices 返回退出码 0xc0000005(访问冲突),前一行还有一条警告说没在输出里找到 system_info 行、CUDA 架构过滤会被关掉;紧接着下一行就是 Vulkan 把卡认了出来——description="Radeon RX 580 Series",总显存 8.0 GiB,可用 7.2 GiB,并且按这个数字把默认上下文设成了 4096。
还有一件第一次启动才会遇到的事:它在 ~/.ollama/ 下生成了一把 ed25519 密钥,终端里直接把公钥打了给你看。这是登录云端模型时用的身份,和以前的「账号密码」不是一套东西。
跑起来:1.7B 在 RX 580 上是 33 tokens/s
我拉的是 lfm3,Liquid AI 那个 1.7B、宣称 256K 上下文的本地代理模型,包大小 1.1 GB。用 --verbose 跑一轮中文提问,数字是这样的:加载 10.87 秒,prompt 处理 15.41 tokens/s,生成 33.36 tokens/s,整轮耗时 24.53 秒。ollama ps 里显示 100% GPU,上下文 4096。
33 tokens/s 对一个 1.7B 模型不算快,但这张卡是 2017 年的,靠 Vulkan 图形后端跑推理,能到「读起来跟得上」的程度已经超出我预期。真正要注意的是那个 4096——它是服务按 8 GB 显存自动算出来的默认值,不是模型宣传的 256K。想让上下文变长,得在启动服务时把 OLLAMA_CONTEXT_LENGTH 提上去,代价是显存。
另外有个小细节:这一轮它生成了 410 个 token,其中一大段是自言自语,终端把「Thus final answer: one sentence. …done thinking.」这类思考草稿也打了出来。小模型的思考通道和正文经常混在一起,这不是 bug,但会让脚本抓输出的人多写几行过滤。
接上 Claude Code:接通了,1.7B 接不住
ollama launch claude --config --model lfm3 只带 --config 会停在一句 Launch Claude Code now? requires confirmation 上,得再加 --yes。加了 --yes 之后它开始装 Claude Code,然后这台 Windows 机器上刷出六十多行 PowerShell 红色报错,每一行都在抱怨 HTML 里的 "@context":"https://schema.org" 不是合法语句。
原因不复杂:https://claude.ai/install.ps1 在现在这个网络环境里返回的是 302,跳到 claude.com/app-unavailable-in-region,正文是网页。Ollama 把这段网页原样喂给了 PowerShell 的 iex。它没有校验拿回来的到底是不是脚本,于是一个干净的「你所在地区不可用」,变成了一屏语法错误。这对国内的读者不是小概率事件,值得记一笔。
绕过去的办法是自己装。我用 npm 装了 @anthropic-ai/claude-code 2.1.318,把三条环境变量指到本地服务,claude -p 能跑通——它连上了,也确实收到了回复。
问题在于回复的内容。我让它列出当前目录下的文件名,它回的是「I’ve noted the setup details… 有什么需要我做的吗」,一次工具调用都没有发起。换一句更直的指令再试,还是同样的东西:把系统提示里的环境说明复述了一遍。两次分别耗时 47.84 秒和 99.57 秒。
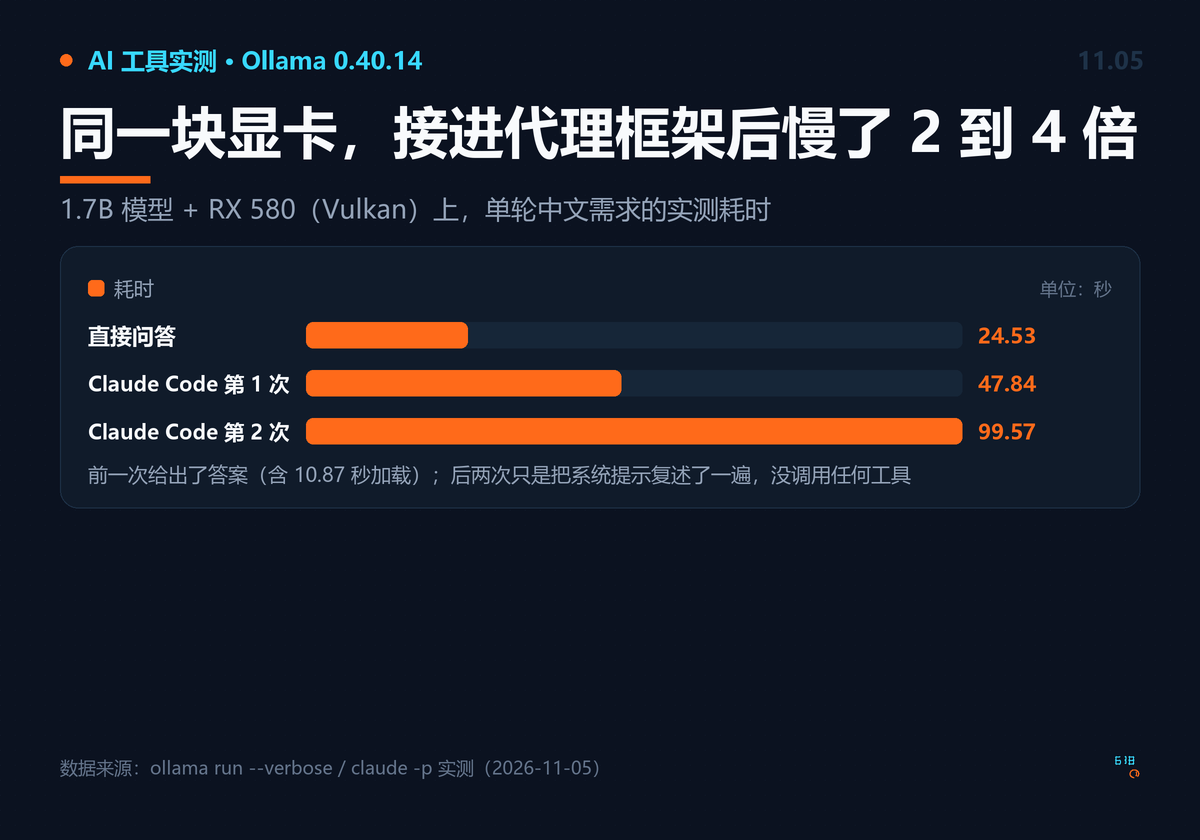
第二轮里 Claude Code 还抛了一条警告,说它不认识 lfm3 这个模型名,于是按 200k 上下文处理。而 Ollama 那边实际给的是 4096。一边以为能读二十万 token,一边只给四千,中间差 48 倍,这就是为什么长文件一进去就开始丢东西。
接本地模型之前,先把两边的上下文口径对齐。 要么给 Ollama 起一个 32k 到 64k 的 OLLAMA_CONTEXT_LENGTH,要么在 Claude Code 侧显式声明模型的窗口大小,别让两边各猜一个。
判别模型这条路,门槛比宣传高
0.40 这条线上另一半新东西是判别模型:给它一段文本、一段 JSON 甚至一张图,问一个是非题、选择题或打分题,它返回概率而不是一段话。接口是 /v1/systemone,choice 给每个选项的概率,noul 给「是」的概率,score 给按档位加权后的分数。这个形状对做分类、路由、工单分派的人很有吸引力——你不需要模型会说话,只需要它敢下判断。
我本想把这条路也跑出数字,三个模型全卡在体积上。clef 是 Cloudflare 拿 Qwen3.8-27B 微调出来的 27B 判别模型,本地文件 18 到 20 GB;nimble 的单个权重文件下到 9 GB 还没结束;d1:2b 名字里带 2B、看着最小,却直接报 this model requires MLX support, but the MLX runtime is not available——默认的 Windows 包里没有 MLX 运行时,那在另一个 881 MB 的包(ollama-windows-amd64-mlx.zip)里。一台只有 8 GB 显存的机器,光下载这一关就过不去。
所以关于判别模型,这次只能给到接口形状、设计意图和官方跑分:官方模型页给出的中位延迟是 clef 209.3 毫秒、小一号的 clef-flash 38.8 毫秒,业务场景端到端准确率在 57% 到 77% 之间。这个延迟数字是它最吸引人的地方——一次前向就把所有选项一起打分,不用逐字生成,所以判别可以嵌进请求链路里当闸门用。想试判别模型,先看清楚模型体积再动手,别像我一样在下载环节把耐心用光。
免费额度的真相:本地不限量,云端按 token
官方定价页把话说得很直白:在自己的硬件上跑模型,永远不限量、不收费。这句话是真的,代价只是电和显卡。
云端是另一套账。按量付费(Pay as you go)从 0 开始,按模型单价扣 token,3 个并发请求;Pro 每月 20 美元,含 60 美元额度,并发仍是 3;Max 每月 100 美元,含 300 美元额度,并发提到 10;Team 每月 500 美元,含 1000 美元额度、不限人数。闲时价在标准价基础上下调大约一半,适用于工作日 12:00–18:00 UTC 之外和整个周末,比如 deepseek-v4.1-flash 的输入从每百万 0.30 美元降到 0.15,输出从 1.20 降到 0.60。判别模型 clef 在云端按每百万输入 token 0.24 美元计。
有 API 调用量的,现在就去核对闲时定价。 同一批离线批处理任务,挪到周末跑,账面能差一半。
值不值得用
正在用 Claude Code 或者 Codex 但只能本地跑的人,这次更新确实给了你一条不用手写配置的路,ollama launch claude --model <名字> 会把路由和上限都处理掉——前提是对方的安装脚本能下下来。
想统一管住十几套编码代理的人,launch 覆盖十八个集成这件事本身就值钱,你不需要为每个工具记一套环境变量。
不值得的场景也得说清楚。把 1.7B 塞进 Claude Code 当生产力是不成立的,实测两次它连「列个文件名」都没做到;在地区受限的网络里指望 launch 自动装好会浪费半小时;以为装完就有提示缓存,会在长会话里被账单教育。
替代方案分三档。只想在本地跟模型说话、不想碰命令行,LM Studio 的模型管理和界面更省心。只想要个干净的推理进程,llama.cpp 直接跑 GGUF,体积小一个数量级,没有云也没有 launch。要跑多并发的推理服务,vLLM 是正解,代价是 Windows 上装起来很折腾。最后一条最朴素:如果你的用量不大,直接用云 API,单位成本可能比养一张卡更低——本地的免费,从来不是零成本。
你现在可以做的三件事
先跑一次 ollama launch --help,别只照文档。 文档列了五个集成,二进制里有十八个,你要的工具很可能已经支持了,只是还没写进网页。
AMD 老卡先看 Vulkan,不要急着下 ROCm 包。 RX 580 这代卡在 ROCm 那边已经没有位置,而 41 MB 的 Vulkan 后端能把它认出来,跑出 33 tokens/s。启动日志里搜 inference compute 那一行,看到 library=Vulkan 就是走对了。
接代理前先把上下文对齐,接完先做一次「它到底会不会用工具」的测试。 让它读一个文件、跑一条命令,如果它只是把你的要求复述一遍,说明模型撑不起这个框架,换大一号的模型比调参数有用。
附:本文信息来源
一、一手信息
版本与发布说明
- Ollama v0.40.14 发布说明(2026 年 11 月 3 日,launch 的输出上限、OpenAI 兼容端点采样默认值、Codex 路由校验)
- Ollama v0.40.13 发布说明(LFM3 扩展到 Linux 与 Windows)
- Ollama v0.40.12 发布说明(LFM3 家族与 d1 判别模型,注明当时仅支持 Apple 硬件)
- Ollama v0.40.11 发布说明(语音生成与 d3 判别模型)
命令行与集成
- CLI 参考:launch 子命令与官方列出的五个集成
- Claude Code 集成说明:launch 用法、
--yes非交互模式、直连云端的写法 - Anthropic 兼容层:支持与不支持的完整清单
- Claude Code 模型配置文档(自定义模型窗口大小)
- npm 上的 @anthropic-ai/claude-code(本次实测版本 2.1.318)
判别模型与云端
- 判别模型说明:
--ask、--choice、--level的用法与返回格式 /v1/systemone接口参考:三种题型与概率字段- 云端说明:
:cloud后缀与登录要求 - 定价页:各档套餐、并发数、模型单价与闲时价
模型页
相关阅读
- 实测 agent-desktop 1.1.0:不截图,让 Agent 直接读 Windows 的控件树
- 本地跑大模型要多少显存:2026 年攒机的账要重算
- 上周 AI 圈重大事件(10.26–11.1):钱比上一轮难拿了
本文为公开信息整理与实测记录,版本号、命令与价格以 Ollama 官方页面当天状态为准。
原创声明:本文由 618A 情报站整理撰写,基于公开信息与实测记录,转载请注明出处并保留原文链接。