这两天有两条消息,看着分属安全和硬件两个板块,其实在说同一件事:能造出来的东西已经够多了,卡住的是消化它们的那一环。
找出 948 个漏洞之后,OpenAI 说瓶颈不在发现
十一月四日,OpenAI 发了一篇叫《通往 root 的路径,减少一千条》的研究文章,隔天又推出网络安全专用模型 GPT-6 Cyber。真正值得读的是前一篇,因为它把整件事的价格摆出来了。
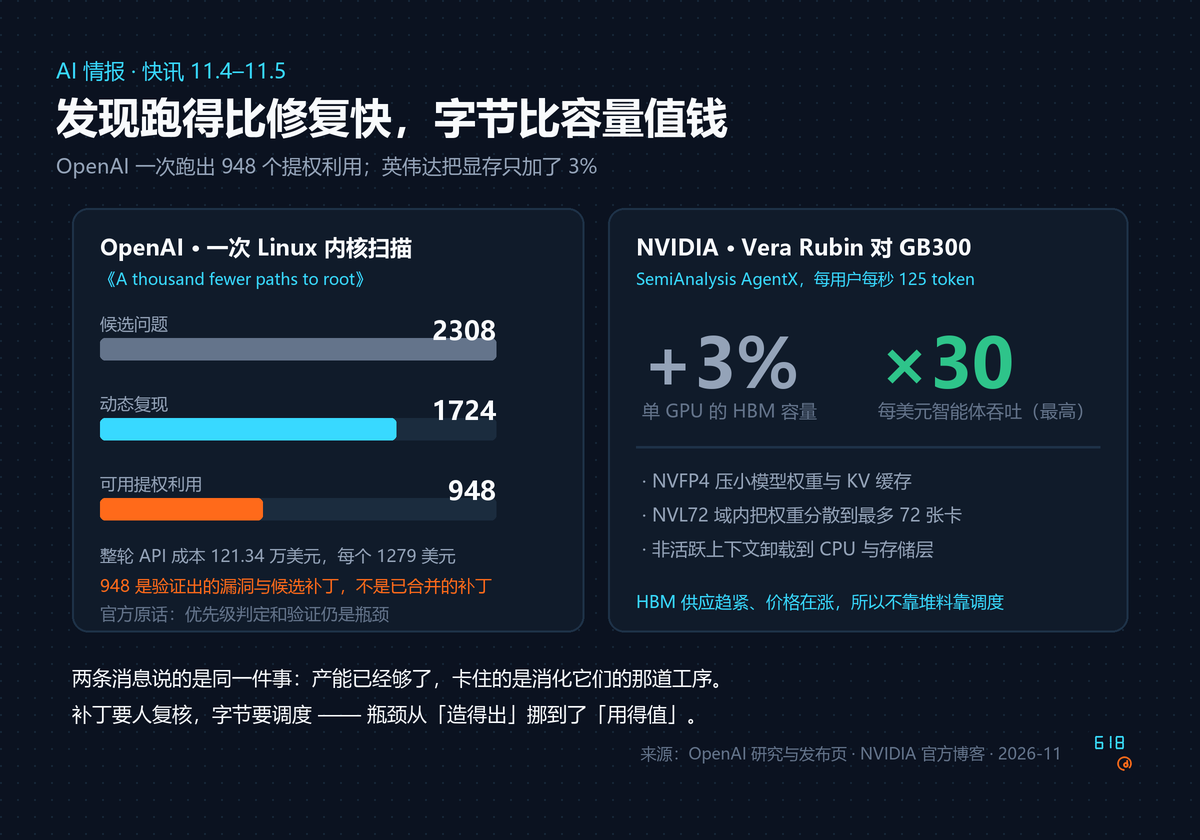
研究团队搭了一条五段的自主流水线:静态扫描圈出内核里与安全相关的部分,在隔离环境里动态复现,写概念验证程序证明可利用性,生成候选补丁,最后交人类研究员复核。一次跑下来,2308 个候选项里动态复现了 1724 个漏洞,最终做出 948 个可用的本地提权利用——在标准的桌面发行版上,一个低权限用户能借它们拿到 root。
这轮跑掉 121.34 万美元的 API 额度,平均每个提权利用 1279 美元。对照 Pwn2Own 和 TyphoonPWN 历史上给同类漏洞开的两万和七万美元赏金,OpenAI 自己算出的倍数是 16 到 55 倍。
这里有个被不少转述写错的地方:948 不是「已经打好的补丁」,是「验证出的漏洞加候选补丁」。文章里那句更该被摘出来的是——漏洞发现正变得更容易规模化,但优先级判定和验证仍是实际工作中的瓶颈。同一段还写着,流水线跑的那十天里,他们观察到一百多个 Linux 提权漏洞被其他贡献者修掉或进了暂存补丁,另有约三百个还在公开讨论。发现的速度已经跑在修复前面了。
十一月五日的 GPT-6 Cyber 补上了模型这一侧:ExploitGym 得分 48.5%,上一代 32.1%,在 OpenAI 自己的准备度框架里从 High 升到 Critical;它给出证据让 Mozilla 把 81 个此前未知的 Firefox 漏洞定为高危,另发现 30 个已知问题比原先报告的更严重。发放方式和上周 Gemini 4 Carbon是一个路子——先只给经审核的 Daybreak Red 客户,走 API 和 Codex,之后再逐步扩大。
把这条新闻当「模型更会挖洞」来读,会漏掉最要紧的那一半。对用开源组件搭系统的团队来说,真正的变量是:扫描已经变成一项可以按预算排期的固定开销,而稀缺的是能复核证据、决定先报哪一个、并把它推进上游的人。
显存只加了百分之三,英伟达把账算到了每一个字节上
同一天,英伟达在官方博客里给了另一组数字。从 Blackwell Ultra 到 Vera Rubin 平台,单颗 GPU 的 HBM 容量只涨了约 3%,而 SemiAnalysis AgentX 测试里,Vera Rubin NVL72 相比 GB300 NVL72 的每美元智能体吞吐最高提升 30 倍。
前提写得也很直白:模型越来越大、上下文越来越长、智能体动辄把三百万 token 的轨迹带进推理,HBM 供应却在收紧、价格在涨。英伟达的比喻是仓库和装卸口——仓库再大,出货速度由装卸口决定,堆到某个点之后,多出来的容量既用不上,也照样耗电、照样花钱。
解法不靠堆料,靠调度:用 NVFP4 把模型权重和 KV 缓存压小,在 NVL72 域内把权重分散到最多 72 张卡上,把暂时不活跃的上下文卸载到 CPU 内存和更便宜的存储层,等需要时再提前搬回来。它要优化的不是「装得下多少」,是「每个字节干了多少活」。
这组和上月底那份装机清单正好对上:同一块内存,零售端还在因为原厂把产能挪去做 HBM 而一天一个价,数据中心端已经开始想办法少用一点。如果你在给推理集群做预算,别再把显存容量当采购的第一指标,先问每美元能跑完多少有效请求。
两条消息合起来看,安全侧的瓶颈从「找得到吗」挪到了「修得过来吗」,算力侧的瓶颈从「加得起吗」挪到了「用得值吗」。变化的都不是产能,是产能之后那道一直没人认真定价的工序。
一、一手信息
- OpenAI《Introducing GPT-6 Cyber》(2026-11-05,ExploitGym 48.5% 对 32.1%、准备度框架升至 Critical、81 个 Firefox 高危漏洞、Daybreak Red 分批开放):https://openai.com/index/introducing-gpt-6-cyber/
- OpenAI 研究文章《A thousand fewer paths to root》(2026-11-04,2308 个候选、1724 个动态复现、948 个本地提权利用、121.34 万美元 API 成本、每个 1279 美元、官方明确「优先级判定和验证仍是瓶颈」):https://openai.com/index/a-thousand-fewer-paths-to-root/(中文版)
- NVIDIA 官方博客《More Performance From Every Byte》(2026-11-05,HBM 供应趋紧与涨价、NVFP4 压缩权重与 KV 缓存、NVL72 权重分散、非活跃上下文卸载、SemiAnalysis AgentX 口径下 HBM 增约 3% 而每美元智能体吞吐最高提升 30 倍):https://blogs.nvidia.com/blog/memory-full-stack-codesign/
二、媒体报道
- 腾讯新闻《刚刚,OpenAI 发布 GPT-6 Cyber:挖出 Firefox 81 个高危漏洞,Linux 948 条提权攻击路径》(中文核对 948 为「有效本地提权利用」而非已合并补丁、GPT-5.6 Sol 同期对照 166 个、ExploitGym Honeypot 边界对齐测试):https://news.qq.com/rain/a/20261106A03EJO00
- 腾讯新闻《全球科技早参》(2026-11-06,英伟达内存全栈协同、谷歌怀俄明州 170 亿美元数据中心与 702 兆瓦燃料电池、11 月 5 日纳指跌 5.5%):https://news.qq.com/rain/a/20261106A03M8T00
- 通信世界《HBM 仅增 3%,每美元吞吐提升 30 倍》(SemiAnalysis AgentX 的测试条件为每用户每秒 125 token、GB300 NVL72 对 H200 平台 10 倍的对照):https://www.163.com/dy/article/LB1P06VC051288FS.html
- 财联社《英伟达提出 AI 内存全栈协同设计方案》(中文口径复核 3% 与 30 倍、NVFP4 与上下文卸载的具体做法):https://cj.sina.com.cn/articles/view/5115326071/130e5ae770200343wk
原创声明:本文由 618A 情报站整理撰写,基于公开信息与实测记录,转载请注明出处并保留原文链接。