这两天最重要的两条消息方向相反:10 月 16 日,商务部与科技部把大模型、智能体、算力集群写进拟管制的出口技术清单;10 月 17 日,DeepSeek 又换了一版模型。另两条是技术侧的:Claude 交出更省的量子电路,Reflection 的 Beam 权重落地。
十月十七日,DeepSeek 把「许愿式编程」做成了默认能力
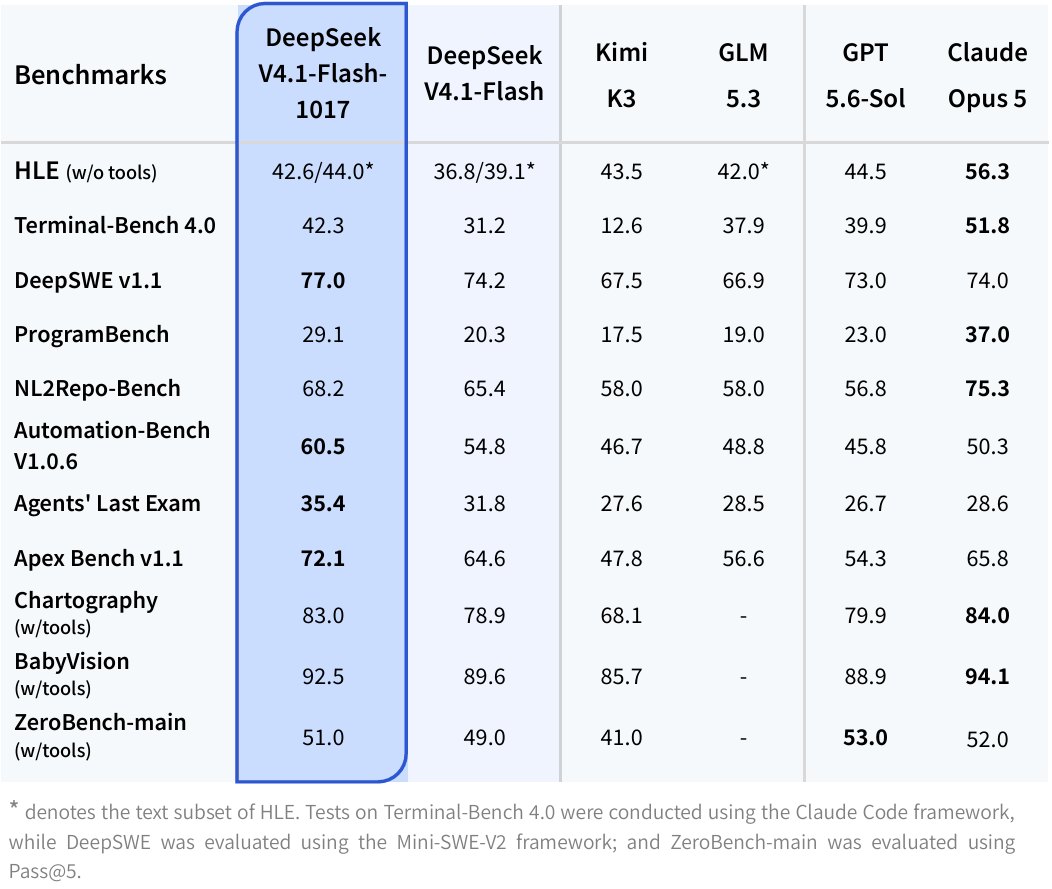
10 月 17 日下午,DeepSeek 把 V4.1 Flash 换成 V4.1-Flash-1017,网页、App 与 API 三端同步,模型名仍是 deepseek-flash。权重当天在 Hugging Face 与魔搭放出,沿用 MIT 许可,结构没动。
官方对照表里,进步集中在多步执行的几栏:Terminal-Bench 4.0 从 31.2 抬到 42.3,ProgramBench 从 20.3 到 29.1,DeepSWE v1.1 从 74.2 到 77.0。按官方口径,DeepSWE 一次任务的平均花费从约 3.3 元降到约 1.3 元。它没有全面领先:Chartography、ZeroBench-main 与 HLE 仍是 Claude Opus 5 与 GPT 5.6-Sol 更高。
真正的新东西是「许愿式编程」:一句话说清要什么,规划、写代码、运行、检查、改错都由模型自己推,官方演示里有故宫三维建模、用 Godot 复刻《传送门 2》。背后是自反馈强化学习——模型写完第一版不交差,自己跑一遍再回头改。要跑顺这套流程,Harness 得升到 0.2.1-rc.1 以上。
同日开放的还有自研搜索接口,Search 与 Fetch 各按每千次 0.75 美元计价;经 Harness、Claude Code、Codex 走的服务端调用目前免费,北京时间 11 月 1 日起按次计费。
十月十六日,商务部把大模型和算力集群写进拟管制清单
10 月 16 日,商务部与科技部发布 2026 年第 48 号公告,就修订《中国禁止出口限制出口技术目录》公开征求意见。这一轮拟增列 40 项,人工智能 23 项,覆盖大模型、智能体、算力集群与信息处理,另有生物医药 5 项、光伏 12 项。发言人的说明是:40 项里拟禁止出口 14 项、拟限制 26 项——AI 一侧列进禁止的是「人工智能驱动的恶意代码生成与变异技术」,列进限制的是「人工智能辅助漏洞挖掘技术」。
比清单更该先看的是同步生效的登记要求。从公告发布之日起到目录正式修订实施,出口这些技术要先在商务部业务系统统一平台登记,四种情形都算:转让技术所有权、授权境外使用、所有权人或实际控制人变更为境外主体、商务部另行要求的情形。已经开始但没做完的出口也在范围内。
公告留了两道口子。已通过开源、发表论文进入公共领域的技术,拟不纳入管理;开源、中企在境外自建自营算力中心、赴境外流片、联合研发、参与国际标准制定,这几类出口适用自动许可,基本「即报即出」。征求意见截止到 11 月 15 日。
同一天,Claude 交出的量子电路比已发表的最好方案更省
10 月 16 日,Anthropic 公布了一项来自 STEM Fellows 项目的研究:把八条量子电路的功能用白话写清楚交给 Claude Mythos 5,再配一个独立的评分程序,模型自己改自己,中间没有人插手。评分标准是量子比特数乘以门数,一个粗糙但客观的运行时间代理量。
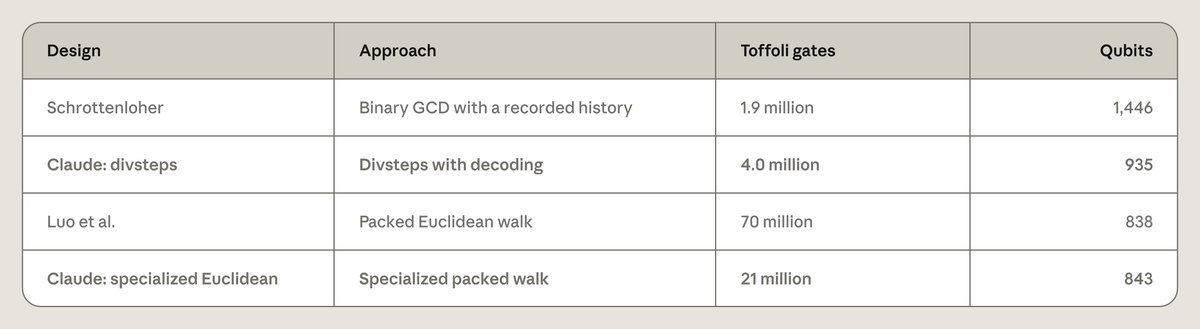
结果是七条电路的门数与量子比特数同时低于已发表的最好设计,部分差距在一个数量级以上。第八条换了方向:椭圆曲线点加法上,Claude 的设计比最小的已有方案多用 12% 的量子比特(935 对 838),门数却少了 17 倍(400 万对 7000 万个 Toffoli)。关键在那一步模逆——经典算法 divsteps 要记下每次分支,量子电路丢不掉中间态,Claude 改成从中间数值反推,导出一组新的代数恒等式,再用 Lean 写成可校验的证明。另一处是解码量子干涉的解码器,用 Berlekamp–Massey 换掉谷歌此前的算法,门数降约 12 倍。
边界也要说清楚。论文是 arXiv 预印本,未经同行评议;所有对比都是纸面资源计数,没有一条跑在真机上。它证明的是「在能自动判分的题目上,模型可以自己找到新结构」,不是「量子计算机快到了」。
Beam 的权重终于落地:Apache 2.0,起步四张 B200
10 月 16 日,Reflection 把 Beam 的权重放上 Hugging Face,Apache 2.0,距离 10 月 5 日「本月内开放」的承诺 11 天。5010 亿总参数、每个 token 激活 230 亿,100 万上下文,纯文本输入,256 个专家里每个 token 走 8 个。
开放得干脆,门槛一点没降。BF16 权重约 1TB,NVFP4 版本压到约 280GB,Hugging Face 建议备四张 B200(合计 720GB)才够放权重加长上下文。Reflection 一并放出 40 多个生态伙伴和 Rust 版 Mirror 命令行工具,宣称的分数是 SWE-bench Verified 81.6%、Terminal-Bench 2.1 80.1%,都是自家口径。
同样是开放权重,前一天 Meta 的 Muse Spark Open 走另一条路:下载要填表、人工审批,产品里得标「Built with Muse Spark Open」,年收入超 2000 万美元还要卖模型服务的,得先另签协议。两家都放出了权重,能拿到手的程度不一样。
这两天你可以做什么
重跑一遍手上的 agent 任务,再决定要不要改提示词。这版收益集中在多步长任务上,重写提示词不一定划算。
避开峰时跑批量任务。DeepSeek 的峰时是 UTC 01:00–04:00 与 06:00–10:00,即北京时间 09:00–12:00、14:00–18:00,周一至周五;输出价格峰时每百万 token 1.2 美元,闲时 0.6 美元。
附:本文信息来源
一、一手信息
DeepSeek V4.1-Flash-1017(10 月 17 日)
- DeepSeek 更新日志:DeepSeek-V4.1-Flash-1017(官方逐项基准、许愿式编程的训练方法、Search 与 Fetch 接口同日开放)
- DeepSeek 模型与价格页:Models & Pricing(模型版本对应关系、100 万上下文与 38.4 万输出上限、峰谷两档价格、Search 与 Fetch 每千次 0.75 美元、11 月 1 日起计费)
- 魔搭模型页:DeepSeek-V4.1-Flash-1017(权重与许可证)
- Hugging Face 模型页:DeepSeek-V4.1-Flash-1017(MIT 许可、配置文件与上一版一致)
出口管制(10 月 16 日)
- 商务部、科技部:公告 2026 年第 48 号 就修订《中国禁止出口限制出口技术目录》公开征求意见并对相关技术出口实施临时登记管理(三个领域 40 项技术、23 项 AI 技术、公开领域豁免、四种登记情形、10 月 16 日至 11 月 15 日的征求意见期)
- 商务部新闻发言人:就修订《中国禁止出口限制出口技术目录》答记者问(拟禁止 14 项与拟限制 26 项的具体条目、自动许可的适用范围)
Anthropic 量子电路(10 月 16 日)
- Anthropic 研究博客:Designing more efficient quantum circuits with Claude(八条电路的闭环设计流程、评分函数、FeMoco 的历史降幅、作者与合著者)
- arXiv 预印本:Discovering state-of-the-art quantum circuits with large language models(2610.22367,10 月 15 日提交,含逐任务资源表与 Lean 形式化)
Reflection Beam(10 月 16 日)
- Reflection 官方博客:Beam is now available(Apache 2.0 权重、40 多个伙伴、Mirror 命令行工具、三种精度格式)
- Hugging Face 模型仓库:reflection/Beam-1.0-501B-A23B(权重与模型卡)
二、媒体报道
DeepSeek 新版本
- 上海证券报(网易):DeepSeek新模型:更聪明,还更省钱(逐项基准的前后对比、帕累托改进的官方定性、API 价格维持不变)
- 智东西(今日头条):梁圣又掀桌了!DeepSeek新模型斩杀GPT-6,许愿式编程时代降临(DeepSWE 77.0% 与单任务成本从 3.3 元到 1.3 元、Search 与 Fetch 的定价换算)
- 新浪财经:DeepSeek上新,「许愿式编程」成为现实(官方微信图示的解读、针对 DeepSeek Harness 与 WorkBuddy 的专项优化)
- 金羊网:DeepSeek又上新!网友排队点赞:「这版真香」(权重在 Hugging Face 与魔搭的下载地址、三端同步切换)
出口管制
- 新华社(中工网转发):商务部详解修订《中国禁止出口限制出口技术目录》(40 项技术的构成、14 项禁止与 26 项限制、发言人对开源豁免的完整表述)
- 中国新闻网:官方拟修订《中国禁止出口限制出口技术目录》(公告发布日、三个领域的项数、出口前登记的临时措施)
- 中国经济网:商务部、科技部拟修订《中国禁止出口限制出口技术目录》 增列部分人工智能、生物医药、光伏技术(公告全文与答记者问的合辑)
量子电路
- ExplainX:Claude Designed Quantum Circuits That Beat the Best Published Ones(53 小时单次运行、12% 比特对 17 倍门数的取舍、Lean 形式化的位置)
- OrcaRouter:Claude Mythos 5 Found Quantum Circuits Better Than the Published Best(论文 46 页、八条任务中七条同时降比特与门数、评估器与被评估者的分离设计)
- Web Pulse:Claude worked alone for 53 hours and beat the best published quantum circuits(403 万次采样解码、665 个比特的最坏情况、Berlekamp–Massey 的替换)
Beam 权重
- TSNMedia:Reflection 把 Beam 权重放上 Hugging Face,Apache 2.0 许可(1TB 的 BF16 检查点、NVFP4 约 280GB、四张 B200 的建议、自报基准的完整清单)
- TensorFeed:承诺 11 天后,Reflection 把 Beam 的权重放了出来(与 Muse Spark Open 的许可逐条对照:署名要求、2000 万美元门槛、需要审批的下载)
- ArtificialWatch:DeepSeek upgrades V4.1 Flash to the 1017 build(结构未变、开放权重沿用 MIT、峰谷价格与上下文上限)
三、其他
- Meta Muse Spark Open 模型卡与 Muse Model License 条款(许可对照所依据的一手文本)
- DeepSeek Harness 0.2.1 版本说明
- Anthropic STEM Fellows 项目介绍页
本文为公开信息整理与解读,数据以各厂商官方口径为准。
相关阅读
原创声明:本文由 618A 情报站整理撰写,基于公开信息与实测记录,转载请注明出处并保留原文链接。