十一月十日起,MinerU 连发了四个版本:4.2.0 在十号,4.2.1 在十一号,4.2.2 在十三号,4.2.3 在十六号。这批更新的重点不在模型,而在「跑起来的边界」——单文件执行超时、Router 回收卡死的 worker、文档库全文检索被内嵌图片的 base64 挤爆、vLLM 和 transformers 版本不兼容时提前拦下来。换句话说,它开始认真处理「长时间跑、跑一半崩、崩了不知道」这类运维问题。
我在这台 2013 年的机器上装了一遍:Xeon E5-2690 v2,20 个逻辑核,32 GB 内存,一块 Radeon RX 580 8 GB。同一份 17 页的 arXiv 论文跑了四个档位,又拿一份 6 页的中文行业报告做对照,顺便把上周 Docling 那份测试的数字摆在一起看——同样的文件、同一台机器,两家的强项和坑位刚好错开。
还有一件事得先说清楚。上周写 Docling 那篇时,我说这台机器「没有显卡」——其实是 torch 看不见它,不是卡不在。MinerU 走的是 DirectML,硬件诊断三秒钟就把 Radeon RX 580 认出来了,显存按 D3D12 报的是 8,567,902,208 字节,折合 7.98 GiB。所以上篇那句话该改成:这台机器的显卡,torch 用不上,DirectML 用得上。
装它:一条 pip,但镜像得先换
在 PyPI 直连上装 mineru==4.2.3,下载断在 3.4 MB 处,报的是 IncompleteRead。换清华镜像,pip index versions mineru 直接回「No matching distribution」——那个源上根本没有这个包,不是版本旧。最后用阿里云镜像装完,八分钟,环境目录 840 MB,带进来 onnxruntime-directml 1.24.4、gradio 6.32.0、docvortex 0.6.25、mineru-llama-cpp 0.2.2 一整套。
装完先打印版本:MinerU 版本: 4.2.3,Python 版本: 3.13.14。两个命令树的入口都在,mineru 是带状态的文档库客户端,mineru-kit 是无状态的解析与服务工具。
国内装它,pip 直接指到阿里云或腾讯云的源。
硬件诊断先给答案:四个档位都开着,实际只跑到第二个
mineru-kit hardware detect --json 三秒钟出结论:ceiling 是 advanced,设备是 dml:gpu,VLM 引擎选 llama-cpp,默认请求档位是 standard,20 个逻辑核,没有一条 warning。
这个结论是按官方文档的规则推出来的:CPU 少于 4 核只开放 flash,4 到 11 核开放 basic,12 核以上开放 standard,有 GPU 则四档全开;CPU 环境下永远不会自动开放 advanced;ONNX 路径要独显总显存四舍五入后不小于 6 GiB 才直接用 GPU。这台机器 20 核加 7.98 GiB,四项全中。
模型的账也跟着档位走。basic 档要 819 MB、13 个文件,从 ModelScope 下只花了 21 秒,速度在 40 MB/s 上下,其中最大的一块是 591 MB 的公式识别模型 PP-FormulaNet_plus-M。standard 档另外要一套 1.2 GB 的 VLM——MinerU2.5-Pro-2605-1.2B 的 GGUF,里面还有 709 MB 的 mmproj。这些在下模型那一步都是静默的,你只会看到进度条。
17 页论文:flash 十八秒,basic 两分钟
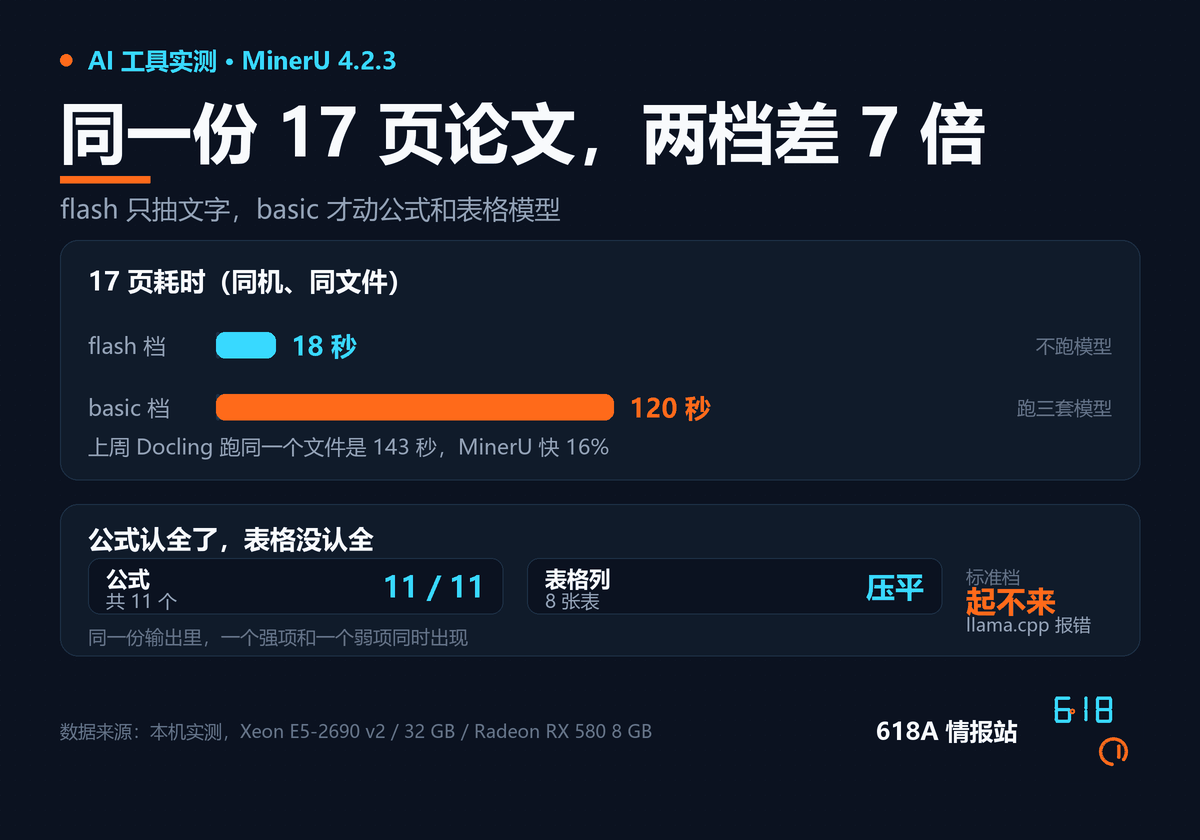
flash 档不跑任何模型,只抽原生文本:17 页用 18 秒,其中推理 12.84 秒,折算 1.32 页每秒。代价是它连公式都不认——输出里一个公式块都没有,只有 9,728 个英文词和 29 个标题,结构有了,数学全丢了。
basic 档把布局、OCR、公式三套模型都跑起来:17 页用 120 秒,推理 110 秒,0.155 页每秒,也就是 6.5 秒一页。时间几乎都花在公式上——公式识别那一环切了 240 个裁片,单它一个就跑了 53 秒。换成纯文字的中文报告就快得多,6 页 17 秒,推理 8.5 秒,0.7 页每秒,出来 1,509 个汉字、8 个小标题。
把上周的数字摆进来对比:同一个文件、同一台机器,Docling 2.149 用了 143.15 秒,8.4 秒一页。MinerU 快 16%,差距不大,属于同一量级。
公式全对上了,表格反倒退了一步
11 个块级公式,一个不少,全部转成了可渲染的 LaTeX——frac、underbrace、operatorname* 这些结构都在,222 处行内公式也是同样的处理。上周 Docling 在这份文件上的成绩是 11 个公式一个都没解出来,这一项 MinerU 是压倒性的。
表格就没这么好看了。输出里确实有管道的表格结构,列头也在,但每一列里三行数据的值被连成了一串:53.2752.6049.78,对应原表里 53.27、52.60、49.78 三个不同的方法。行标签同样被拆开,Qwen3-4B-、Thinking-、2507 分成了三行。八张表里只有一张(校准那张)出成了完整的 HTML 表格,其余都是这种「看起来是表、算不了数」的形态。
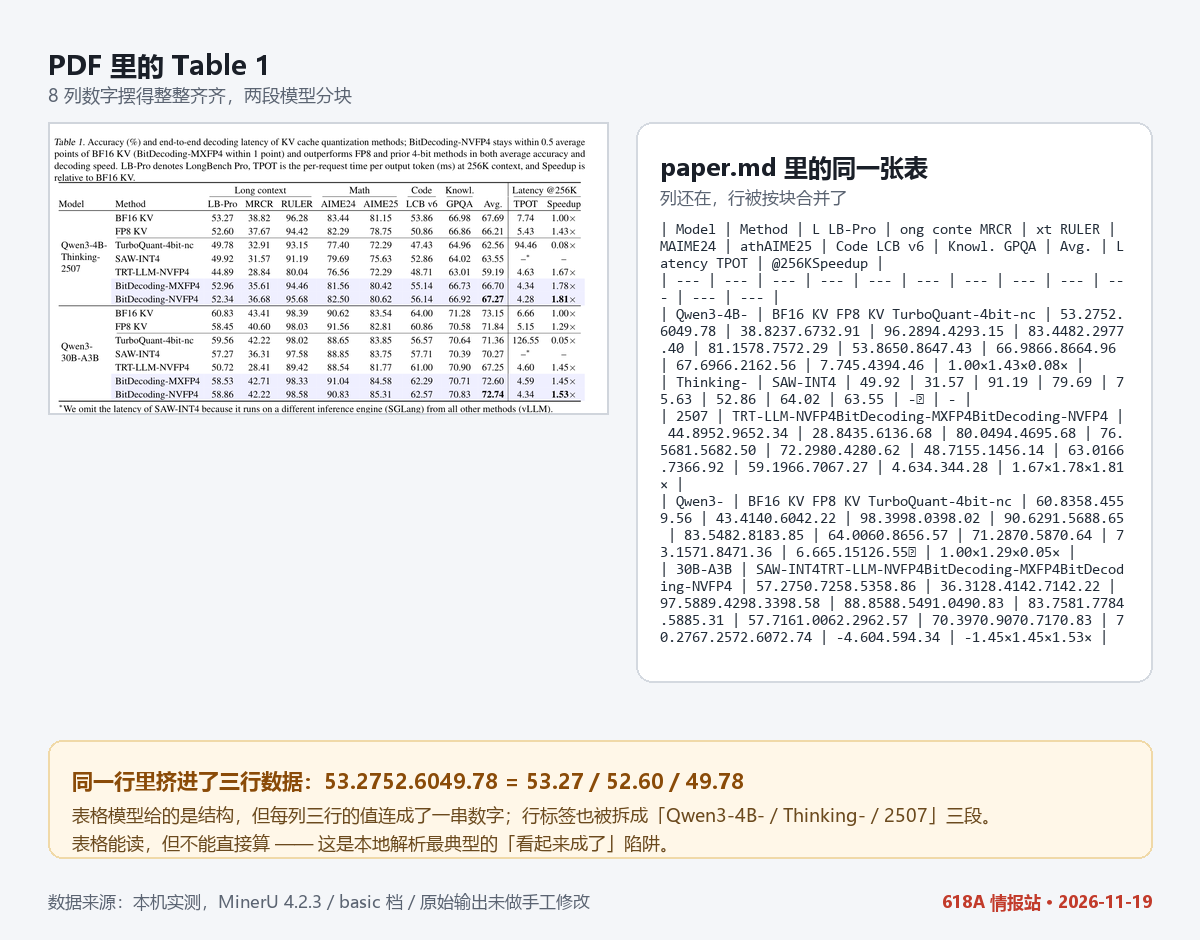
所以选型其实很清楚:论文、标准、带大量公式的文档,可以直接交给它;表格要进数据库或要参与计算的,别指望这一步能省人工。
标准档没起来,报错只有一句话
按硬件诊断的推荐,默认档位是 standard。它先把 1.2 GB 的 VLM 下完,然后七秒钟退出,报的是 Packaged CPU backend is unavailable; check the installation's bin directory。
我试了三种绕法:强制 MINERU_LLAMA_CPP_BACKEND=cpu、强制 vulkan、把 wheel 里的 ggml-vulkan.dll 临时挪走再跑,三次都是同一句话,连行号都没变。可同一套 wheel 里的 llama-server.exe 单独执行 --list-devices 是正常的,能看到 Vulkan0: Radeon RX 580 Series(8192 MiB,7402 MiB 空闲)。
也就是说,不是没有显卡,是打包的运行时在引擎启动那一步没过去,而报错把「后端不可用」和「目录里没东西」混成了一句话。我在 GitHub 上搜这句原文,0 条 issue。
结果就是:这台机器实际能用的天花板是 basic。四个档位开着三个,能用两个。
那条叫 parse 的命令,默认只给你十页
mineru parse paper.pdf -o out.md 看着是最自然的一条命令,实际要过两道关。第一道:报「本地 mineru 服务未运行」,得先 mineru server start,起了七秒。第二道:服务起来后它说「No basic, standard, or advanced engine available」——模型明明在本地躺着,文档库就是不认,只能加 --tier flash。
flash 能跑,17 秒写出结果,但我数了一下页标记:从 <!-- page 1 of 17 --> 到 <!-- page 10 of 17 -->,四万九千字符,后面七页没动。这不是 bug,文档里写了——mineru parse 默认只解析前 10 页,mineru-kit parse、Python SDK、WebUI 默认解析全部页面。同一个产品里两套默认值,差的那七页不会有任何提示。
整份文件交给 mineru-kit parse,或者显式写 --pages all。
模型缓存坏了,它只会告诉你 protobuf 解析失败
这台机器上还留着一个上次尝试的遗迹:十一月十二日下到一半的模型缓存。basic 档第一次跑就死在加载布局模型上,报 Protobuf parsing failed。
删掉整个模型目录重下之后,同一个文件是 213,963,712 字节,加载正常,3753 个节点。而那个坏文件的字节数一模一样——用 onnx 库读,报的是 wire format corrupt。4.2.0 新加的「模型文件清单」只记文件大小、不记内容哈希,所以这种「大小对、内容坏」的情况它抓不出来,只能靠那句 protobuf 报错让你自己猜。
解析突然报 Protobuf parsing failed,先删掉 ~/.mineru/models 重下一次,别去查显卡驱动。
免费额度、许可,和该不该现在换
官方托管的接口是另一条路:每个账号每天有 1000 页最高优先级的解析额度,超出部分优先级降低但仍然能跑,单文件上限 200 MB、200 页;另外还有一个免登录的轻量接口,只收 10 MB 以内的文件、最多 20 页,也只出 Markdown。本地跑不花钱,但要付 840 MB 的环境、819 MB 的 basic 模型,以及一块 DirectML 认得的显卡。
许可不是纯 Apache 2.0:主协议是 Apache 2.0,附加了两条——月活超过 1 亿或月收入超过 2000 万美元,需要单独的商业许可;基于它对外提供在线服务,必须在界面或文档里标明用了 MinerU。仓库到十一月十九日是 83,959 star、6,956 fork,一周四个版本的节奏短期内大概还会继续。
本周你可以做什么
先跑一次 mineru-kit hardware detect --json,再决定下哪个档的模型。 三个档的模型体积差着一倍多,先探再下能省一次 1.2 GB。
装的时候把 pip 指到阿里云或腾讯云镜像。 清华源上现在没有这个包,报的是 No matching distribution,很容易被误读成版本号写错。
要整份文件,用 mineru-kit parse。 mineru parse 只给前 10 页,且不提示。
公式多的论文可以放心交给它,表格要算数就得回原 PDF 核一遍。 列边界丢了这件事,肉眼扫一遍不一定看得出来。
AMD 老卡(RX 500 系这一代)用户,先把期望放在 basic。 标准档在这台机器上是直接起不来的,报错也不指向真正的原因。
本文为公开信息整理与实测记录,命令、默认值、模型体积与许可条款以 2026 年 11 月 19 日安装时的状态为准。
附:本文信息来源
一、一手信息
版本与变更
- MinerU 4.2.3 发布说明(2026 年 11 月 16 日:单文件超时、Router 回收超时 worker、Doclib 检索修复)
- MinerU 4.2.0 发布说明(2026 年 11 月 10 日:WebUI 双向溯源、公式与表格解析、设备选择与安全)
- MinerU 4.2.2 发布说明(2026 年 11 月 13 日:VLM 引擎故障传播、批量解析退出码)
文档与协议
- 命令行文档:
mineru与mineru-kit两套命令树、页数默认值、环境变量清单 - 档位文档:flash / basic / standard / advanced 的硬件门槛与默认选档顺序
- 开源许可(Apache 2.0 + 商业许可门槛与在线服务标注义务)
- PyPI 上的 mineru 4.2.3
- MinerU 项目仓库(本文实测版本 4.2.3)
本次实测的两份文件
- arXiv 2611.09825《BitDecoding-FP4: Native FP4 KV Cache Decoding via Algorithm–System Co-Design》(17 页,含 8 张表、11 个块级公式)
- 中国信通院《云上人工智能可靠性建设指南(2026 年)》(本节取前 6 页做中文排版对照)
二、可替代方案与对照
相关阅读
- 实测 Docling 2.149:17 页 PDF 转完 143 秒,公式一个都没解出来
- 实测 LiteLLM 1.109:升级一个网关版本,五处配置要动手,两处会静默失效
- 本地跑大模型要多少显存:2026 年攒机的账要重算
原创声明:本文由 618A 情报站整理撰写,基于公开信息与实测记录,转载请注明出处并保留原文链接。