十一月十一日早上八点五十六分,LiteLLM 放出了 1.109.0。发布说明第一行写着:982 个 PR,新增 144、修复 424、变更 60、改进 17、删除 9,其中 5 项需要动手改配置。第二天上午十点零七分,1.109.1 跟着出来,只有两个 PR——一个是安全修复回移到稳定分支,一个是版本号。
一个自建大模型网关发到这种体量,值得停下来看一眼。它不像模型发布那样上头条,但它是很多团队所有模型调用的必经之路:切供应商、算成本、拦坏 key、某个厂商挂了换个地方接着跑,都在这层做。版本升错,业务代码一行没动,线上却会开始出问题。
我在这台 Windows 机器上装了 1.109.1,起了一个只认 OpenAI 格式的假上游,把它当成真实供应商来打——测它装起来多贵、起得多慢、每请求多花多少时间,还有这版最值得说的那个新功能:回答说到一半,上游把连接掐了,网关能不能换个模型接着把这句话写完。
装它要 194 秒,起来还要再等 22 秒
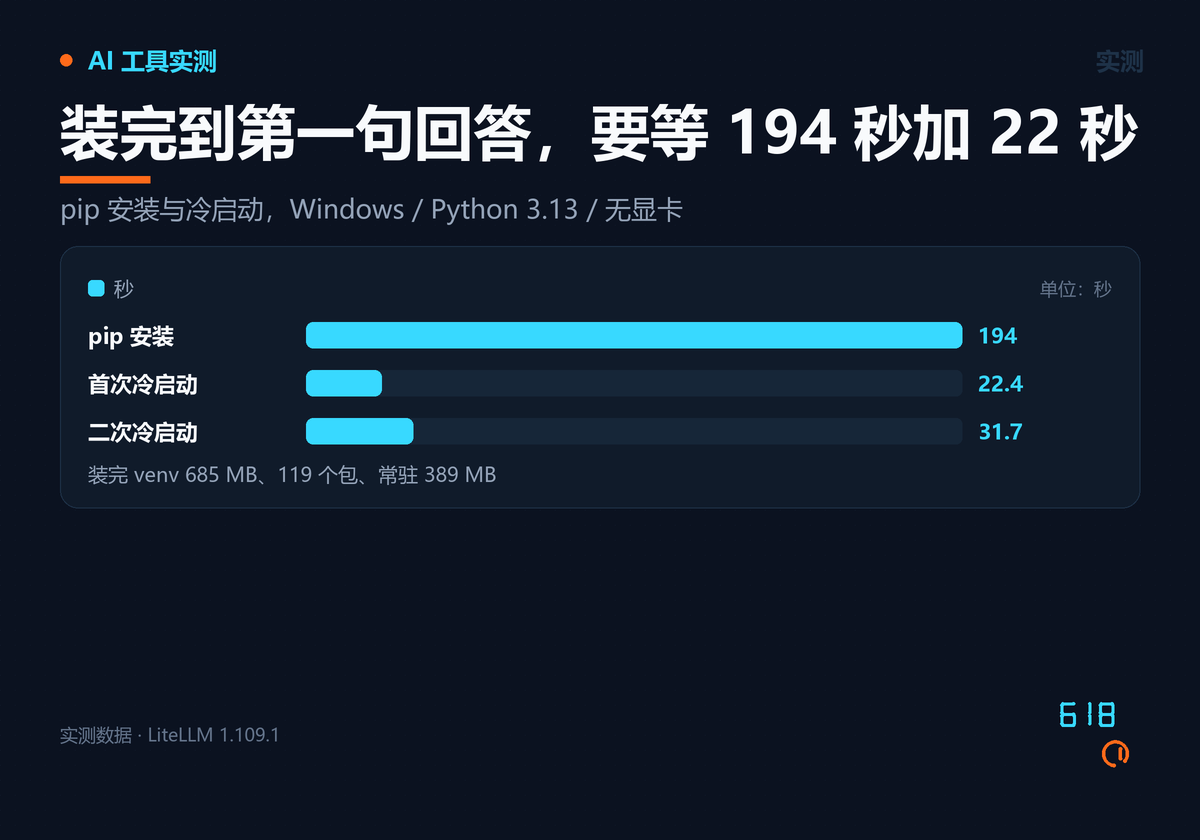
pip install "litellm[proxy]==1.109.1" 走国内源,跑了 3 分 14 秒。装进来的不只是 litellm 一个包,还有 119 个:boto3 和 azure-identity 管各家云的身份,psycopg 是 Postgres 驱动,polars 做数据处理,cryptography 和 pynacl 撑签名,granian、gunicorn、uvicorn 三套服务器都在。整个虚拟环境 685 MB。
装完启动,litellm --config config.yaml --port 4000 到 /health/liveliness 返回 200,第一次用了 22.4 秒,第二次 31.7 秒,起来之后常驻约 389 MB(tasklist 读数 398,504 K)。这个内存对长期跑着的网关不算什么,但冷启动三十秒意味着重启就是半分钟不可用,容器探针的 initialDelaySeconds 得照着这个数配。
老教程里的 master_key: sk-1234,现在会让它拒绝启动
第一次启动没起来。我照着自己三年前写的配置抄了一行 master_key: sk-1234,进程直接抛 UnsafeMasterKeyError,理由写得很直白:the master key is a publicly known default。
退出时它把三步修法打印在终端上:配置里改成读环境变量 os.environ/LITELLM_MASTER_KEY;用 openssl rand -hex 32 生成一个真钥匙写进 .env;不用 .env 的场景(docker run、Kubernetes)就直接给环境变量。最后还留了一个本地开发的逃生门 LITELLM_DANGEROUSLY_PERMIT_WEAK_OR_UNSET_MASTER_KEY=true。
这条拦得对。sk-1234 这种默认值在公网上被扫是必然事件,网关的 master key 又能签发虚拟密钥、读全量花费记录。但副作用是:所有从旧教程、旧 compose 文件复制配置的人,升级之后第一件事是网关起不来。它不会静默,报错也很清楚,只是你得先把这条算进升级窗口。
客户端在请求体里塞 api_base:拦住了,但回的是 500
1.109.1 那个安全回移(PR #51254)修的是这么一件事:客户端可以在请求体里带一些本应由管理员在配置里定的字段,跟部署配置打架,结果是行为不可预期——最坏的情况是客户端指定 api_base,你的网关替它把请求转发到它指定的地址,密钥跟着一起过去。
我按漏洞的形态打了一次:请求体里加 "api_base": "http://127.0.0.1:9101/b/v1"。上游没有收到任何请求,说明拦住了。但客户端拿到的是 HTTP 500,body 就是一行纯文本 Internal Server Error。真正的理由只在服务端日志里:ValueError: Rejected Request: api_base is not allowed in request body. Clientside passthrough requires explicit admin opt-in via either general_settings.allow_client_side_credentials = true or configurable_clientside_auth_params on the deployment,后面还挂了 huntr 上那条漏洞的编号。把 api_base 塞进 metadata 里,同样被拦,同样是 500。
发布说明写的是「客户端会拿到 401」。我这边用 master key 直接调,拿到的是 500。拦截是对的,状态码是错的——500 意味着「网关自己崩了」,客户端和负载均衡会按故障重试,而不是按越权处理。如果你的服务前面有重试中间件,这条会被当成可重试错误白白放大。
不管状态码对不对,结论是一样的:从这一版起,客户端不能再自己指定上游地址。如果你的业务真在用「客户端带上游」这种用法(多租户自带 key、代理转发),得在部署上显式开 configurable_clientside_auth_params,而不是指望它像以前那样默默生效。
流断在半句话中间:24 毫秒后,另一个模型接着写
这版最值得看的新东西是流式回答的断点续接(PR #41127)。以前的 fallback 只管「请求没发出去」和「第一个字节没回来」,一旦流已经开始吐字、吐到一半上游断了,调用方拿到的是半句话加一个错误。做长回答的产品都踩过这个:用户看着屏幕上的句子戛然而止。
现在的做法是把已经吐出去的那部分文本当成 assistant 预填,交给备用部署接着写,两个流拼接成一个。默认关闭,要在 router_settings 里打开 enable_mid_stream_fallback_continuation: true。
我的假上游这样演:主部署吐三段文字,然后把 TCP 直接掐断,连 chunked 的结束块都不发。备用部署正常回答。结果客户端收到的是四段——前三段来自主部署,第四段「,后半句由备用模型接着说。」来自备用部署,整条流只有一个 id,finish_reason 是 stop,HTTP 状态 200。
看服务端收到的请求更清楚:备用部署的 messages 末尾多了一条 role: assistant、content 是那半句话、prefix: true。这就是预填——不是让它重新回答,是让它从断点往下写。
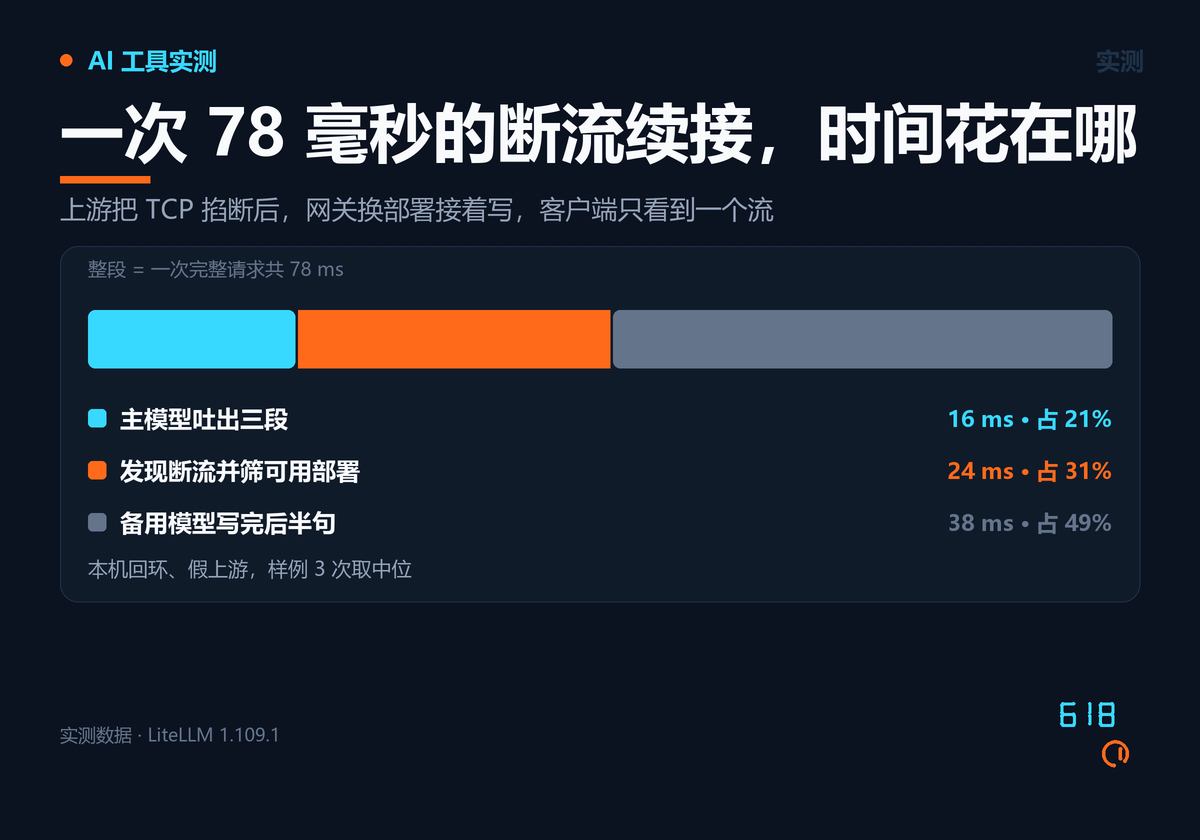
三次连跑,整条请求 75、82、88 毫秒,从前三段结束到备用部署的第一个字,间隔分别是 22、23、25 毫秒。这二十几毫秒里网关要做的是判定流异常、在候选部署里筛出能接预填的那些、发新请求。真实环境里这个数会被网络和备用模型的首字延迟吞掉,网关自己那部分可以忽略。
对用户来说,屏幕上就是一句话写完,只是后面半句换了个人写。这既是功能也是隐患:客户端完全无法从响应里知道中途换过模型——x-litellm-model-api-base 这些头返回的还是主部署,usage 也是拼接后的合计。要审计「这次回答到底是谁写的」,只能去翻服务端日志。
不声明预填能力的备用部署,会被悄悄筛掉
这里有个必须知道的坑。第一次测的时候我没给备用部署加任何声明,结果日志里是这么一行:
Fallback also failed: litellm.MidStreamFallbackError: litellm.APIConnectionError ... No deployments available for selected model, Try again in 5 seconds. Passed model=gw-backup.
备用部署明明活着——前一个 500 的 fallback 测试里刚用过它。原因在筛选逻辑:续接只在「支持 assistant 预填」的部署里挑,判定顺序是先看部署的 model_info.supports_assistant_prefill 有没有显式写成布尔值,没有才去查 litellm 内置的模型能力表。自建的 OpenAI 兼容上游不在那张表里,于是被判定为不支持,整个候选集被筛空。
更需要注意的是客户端看到什么:HTTP 200,一句话正常结束,只是话没说完。没有 5xx,没有错误事件,finish_reason 是 stop。监控上的错误率是零,用户看到的是残句。加上 model_info: {supports_assistant_prefill: true} 之后,同一套配置立刻正常续接。
打开 enable_mid_stream_fallback_continuation 之前,先给每个 fallback 目标写上 supports_assistant_prefill: true。 顺序反了,你得到的就是这条静默截断:错误率是零,用户看到半句话。
五条「必须动手」里,两条不改起不来,一条改了没感觉
发布说明单列了 5 项 Action required,我按最容易被忽略的顺序逐个试了。
删掉磁盘缓存(PR #48114)是最硬的。以前 cache_params.type: disk 能把响应缓存写到本地目录,这版把这个后端连同它依赖的 diskcache 包一起删了——那个包最后一次发版是 2023 年 8 月。配置里留着 disk,启动直接失败,报错原文是 ValueError: Unsupported cache type 'disk'. Supported types: local, redis, redis-semantic, valkey-semantic, s3, qdrant-semantic, azure-blob, gcs。本地单机场景换 local 就行,多实例必须上 redis。
fallback 写成裸字符串(PR #48943)这条以前是静默失效,现在改成启动就报错:TypeError: Fallbacks for 'gw-dead' must be a list of model names, got 'gw-backup'. Use {'gw-dead': ['gw-backup']}。旧写法为什么从不生效,PR 里写得很直接:路由把那个字符串当可迭代对象,一个字符一个字符地试,去请求名叫 g、p、t 的模型,当然一个都找不到,最后抛的还是主部署的错误。所以过去一年里,凡是 fallbacks 写成 {主模型: 备用模型} 的配置,其实从来没起过作用——只是没人发现,因为主部署一直没挂。
第三条最阴:enable_pre_call_checks: true 从 2024 年起就悄悄把 rpm 当成硬闸用,部署在一分钟内的请求数到达 rpm 就被摘出候选,文档里却只写了上下文窗口和地域检查。这版把这个暗行为删了(PR #48873),rpm/tpm 回归成路由权重,真想要硬上限得显式加 optional_pre_call_checks: ["enforce_model_rate_limits"]。靠这个字段防超额的人,上限会在升级那一刻消失,而且不会有任何提示。
剩下两条与国内读者关系不大:Gemini 3.6 Flash 及更新型号不再接受 temperature、top_p、top_k,要么开 drop_params: true,要么自己别发;Lens 要单独部署。
每请求多 23 毫秒,换来的是什么
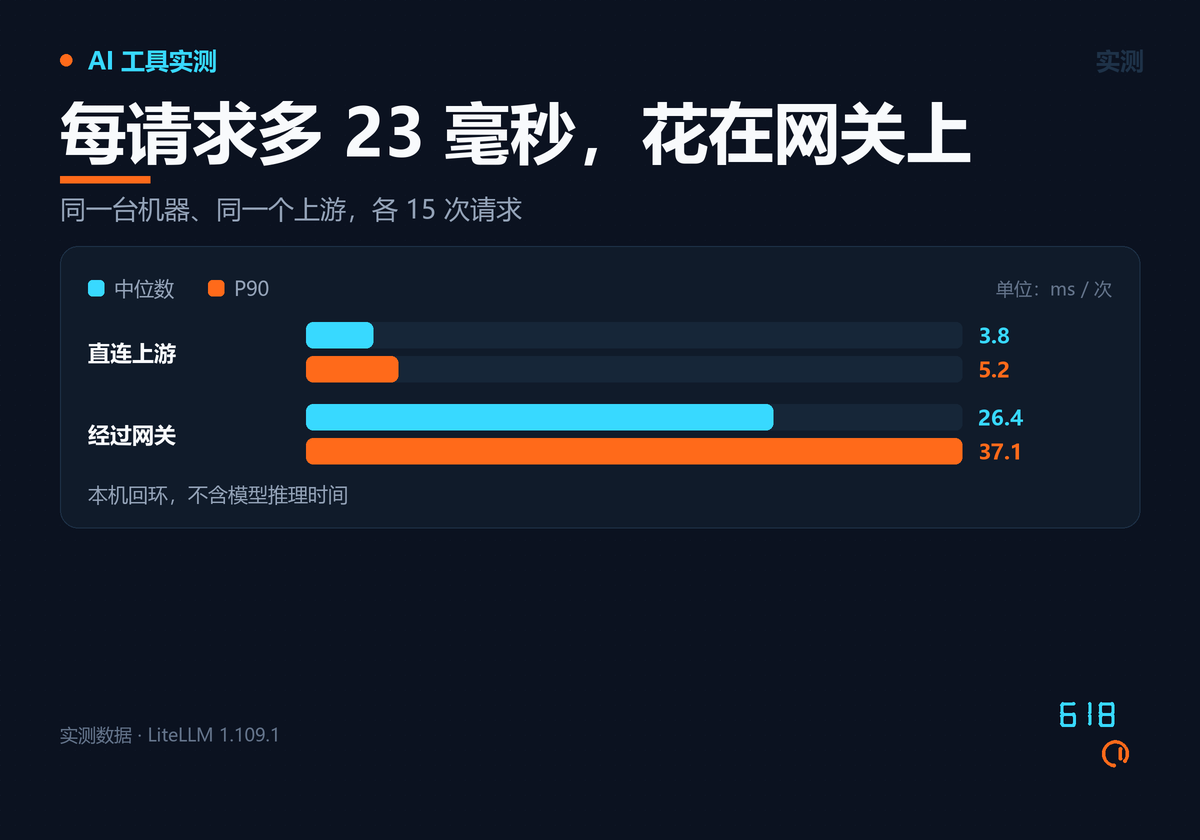
同一台机器、同一个上游,直连 15 次的中位延迟是 3.8 毫秒,过网关是 26.4 毫秒,P90 分别是 5.2 和 37.1。本地回环下这 23 毫秒看着刺眼,是六倍;放到真实链路里,模型首字动辄几百毫秒到几秒,它就是零头。真正要算的账不是这 23 毫秒,而是你需不需要网关提供的东西:多部署故障切换、按 key 记账、密钥不下发到业务侧、模型名和供应商解耦。
免费额度这件事,LiteLLM 没有额度可谈——核心是 MIT,enterprise/ 目录单独授权,自建不按调用量收费,成本是你自己的机器:685 MB 磁盘、389 MB 常驻、三十秒重启。换来的是完全的控制权和一份能改的代码,代价是升级要自己盯 Action required,出问题要自己看日志。
不想自己运维的,同类有托管路线:OpenRouter 一个 key 打通多家模型,按 token 加价,适合小团队和原型;Cloudflare AI Gateway 有免费额度,做缓存、限流、日志比较省事,但对请求形态的限制比自建多;Portkey 和国内常用的 New API 也在这条赛道上,前者偏可观测,后者偏多租户分发。
顺带一句,1.110.0-rc.2 在今天上午十点五十三分已经出现在 Releases 里,加了非流式请求的整请求超时。RC 不要上生产,但它说明这版的坑还在被人填。
这周你可以做什么
先在你的 config.yaml 里搜两个词:type: disk 和裸字符串 fallback。 两处都在启动阶段就炸,不会留到线上才发现。
把 master_key 换成环境变量注入的真钥匙。 os.environ/LITELLM_MASTER_KEY 加 .env,十个字符的改动,换掉一个必然被扫的入口。
给每个 fallback 目标补上 model_info.supports_assistant_prefill: true,再打开 enable_mid_stream_fallback_continuation。 顺序不能反,先声明后开启,否则你得到的是静默截断。
升级后拿一个会中途掐断的假上游跑一次流式请求。 看客户端最后收到的是完整句子还是残句,这是唯一能确认续接真的生效的办法。
如果你的 rpm 是硬上限,补 optional_pre_call_checks: ["enforce_model_rate_limits"]。 不加,那个上限从这一版起就不存在了。
附:本文信息来源
一、一手信息
版本与变更
- LiteLLM v1.109.0 发布说明(2026 年 11 月 11 日:982 个 PR、5 项 Action required、Chat UI、流式断点续接)
- LiteLLM v1.109.1 发布说明(2026 年 11 月 12 日:安全修复回移到 1.109 稳定分支)
- PR #41127:流式回答中断后的断点续接(预填拼接、不续接的六种情形)
- PR #48114:移除 disk 缓存后端,未知缓存类型改为启动时报错
- PR #48943:fallback 目标必须是模型名列表,裸字符串在 Router 初始化时拒绝
- PR #48873:
enable_pre_call_checks不再按 rpm 过滤部署,硬上限改由enforce_model_rate_limits承担 - PR #48096:
LITELLM_OFFLINE_MODE一键关掉网关自己发起的外部请求 - PyPI 上的 litellm 1.109.1
安全
文档
- 可靠性文档:fallbacks、context_window_fallbacks、重试与冷却
- 缓存文档:local / redis / s3 各后端的配置字段
- 配置参考:
router_settings、litellm_settings、general_settings全部字段 - 管理界面文档:Chat UI、模型中心与用量指标
- 生产部署文档:多实例、数据库、探针与超时
替代方案
二、媒体报道
其他
- Portkey Gateway
- New API
相关阅读
- 实测 Docling 2.149:17 页 PDF 转完 143 秒,公式一个都没解出来
- 实测 Ollama 0.40.14:一个 launch 命令,把 18 个编码代理都接了过来
- 实测 agent-desktop 1.1.0:不截图,让 Agent 直接读 Windows 的控件树
本文为公开信息整理与实测记录,命令、默认值与价格以 LiteLLM 官方文档当天状态为准。
原创声明:本文由 618A 情报站整理撰写,基于公开信息与实测记录,转载请注明出处并保留原文链接。