十一月八号,Docling 发了 2.149.0。这一版发布说明里排在最前面的不是模型,是命令行:整个命令结构被重写了一遍,--vlm-model 以前给不给结果都一样,现在会真的切到 VLM 管线。同一版里还塞进一个选项,能把 PDF 里内嵌的原始图片抠出来。
对做知识库的人来说这是绕不开的一个东西:本地跑、不上传、MIT 协议、把 PDF 拆成 Markdown 和 JSON。我在这台没有显卡的 Windows 机器上装了一遍,拿两份真文件跑到底——一篇 17 页的 arXiv 论文,一份 78 页的中文行业报告——想看它到底能把一份 PDF 拆到什么程度。
装它要过三关:包、模型,还有一个环境变量
pip install docling 在这台机器上跑了 5 分 56 秒。装进来的不只是 docling 2.149.0,还有 torch 2.15.0、torchvision 0.29.2、transformers 5.22.2、rapidocr 3.10.0 一整套,以及一个叫 docling-slim 的同版本包。这些里面真正跟文档解析有关的只有一小块,剩下都是模型运行时要用的框架。
装完还不能用。第一次 convert 才会去下模型:版面模型 docling-layout-heron 和表格模型 docling-models(v2.3.0),缓存目录在 ~/.cache/huggingface/hub,两个加起来 506 MB。
这一步在国内几乎必卡。这台机器连 huggingface.co 直接超时,什么都不设就报 LocalEntryNotFoundError: ConnectTimeout [WinError 10060]。把 HF_ENDPOINT 指到 https://hf-mirror.com 之后,两个模型各自十秒出头就下完了,一个是 11.80 秒,一个是 11.55 秒。
先把 HF_ENDPOINT=https://hf-mirror.com 设上,再跑第一次转换。 不设这一步,后面所有命令都会停在同一个报错上。
命令结构换了,帮助里只剩 convert
新版是四个子命令:convert 本地转换、convert-remote 转给 docling-serve 服务、models 列 VLM 与 ASR 预设、options 查某个引擎接受哪些 KEY=VALUE。
旧写法 docling paper.pdf 实测还能跑,默认走的就是 convert,但帮助里已经查不到这条路径了,照着老文章抄命令的人会以为自己写错。docling --version 也退化了:现在只打印 Python: cpython-313 (3.13.14) 和 Platform: Windows-11-10.0.26200-SP0,一个字都没提版本号,只能回头 pip show docling。
命令重构那个 PR 里写着一条真正的行为变化。以前 --vlm-model 给了会被忽略,管线和模型各走各的;现在给了模型名就切到 VLM 管线,而 --pipeline standard 配 --vlm-model 会直接报错。这条对写脚本的人影响最大——参数不报错、结果不对的那类坑,从此变成明着报错。
17 页的论文:143 秒,正文 7.5 万字符,8 张表全中
机器是 2013 年的 Xeon E5-2690 v2,10 核 20 线程,32 GB 内存,没有独立显卡,全程 CPU,--num-threads 4。
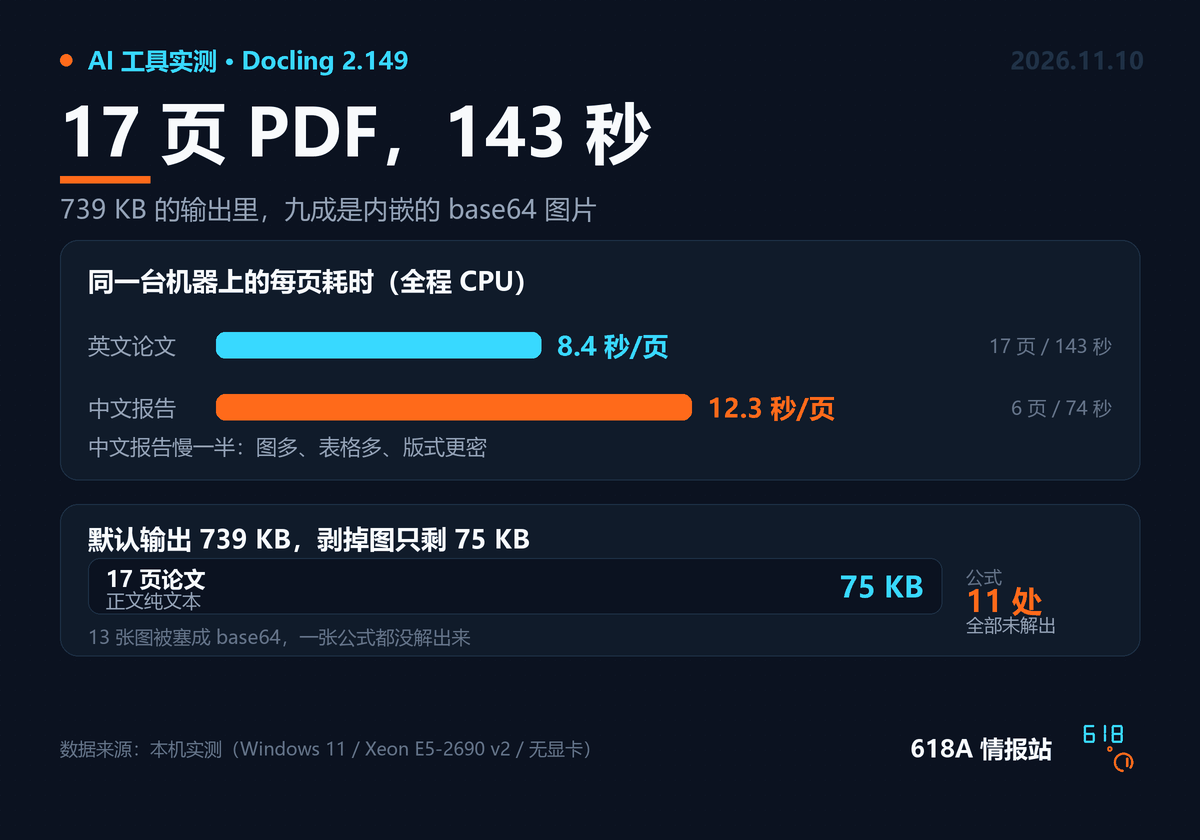
17 页转完用了 143.15 秒,加上模型加载的墙钟时间是 163 秒,折下来 8.4 秒一页。作为对照,用 PyMuPDF 把同样的字抽出来只要 0.21 秒——慢了将近 700 倍,换来的是结构:论文里 29 个标题、8 张表、13 张图,都被单独标了出来。
8.4 秒是「多页一起跑」摊薄之后的结果。单独跑一页要 26 秒,其中只有 7.91 秒是正文时间,剩下全耗在模型加载上。改成一次给一个目录之后,第一份 8.20 秒、第二份 2.86 秒,因为模型只加载一次。
所以批量处理就整目录丢进去,不要一份一份调。同一个目录里放十份文件,从第二份开始成本会掉到三分之一。
739 KB 的输出里,663 KB 是图
默认的 --image-export-mode embedded 会把图片转成 base64 直接写进 Markdown。那 17 页论文吐出来的 paper.md 是 739,541 字节,把 data:image 那一段剥掉,正文只剩 75,485 字符。
图片数量比预想的还怪。PyMuPDF 数出来这份 PDF 一张内嵌位图都没有,Docling 却给了 13 张 PNG,它把论文里的矢量图裁成了位图。
换成 --image-export-mode referenced,输出立刻干净:Markdown 只剩 9,944 字节,图另存进 caict_artifacts/ 目录,正文里是相对路径。有个小坑,输出目录会多出一层同名的子目录(out4/out4/),写脚本拼接路径时要留意。
要把结果塞进知识库的,一律加 --image-export-mode referenced。 默认那套 base64 会把一份 17 页的文档撑到 739 KB,向量化之后大半是噪音。
表格:8 张全中,但合并单元格不会往下填
论文里正好是 Table 1 到 Table 8,Markdown 里也是 8 个表格块,一张没漏。数字对得很准,Table 1 里 BF16 KV 那一行的 53.27、38.82、96.28,跟原文一个不差。
问题在跨行的单元格。原文里 Qwen3-4B-Thinking-2507 这个模型名竖着排、占了四行,Markdown 里它被折成两段:第一行 Model 列是 Qwen3-4B- Thinking-,第二行变成 2507,从第三行起干脆空着。列数仍是 12 列,语法上没有任何错误,但下游按行读的话,会以为 2507 是个新模型。
这条对 RAG 很致命。你按列名去取 Model 和 LB-Pro,拿到的是错位的配对,而且不会报错。
公式:11 处,全部落空
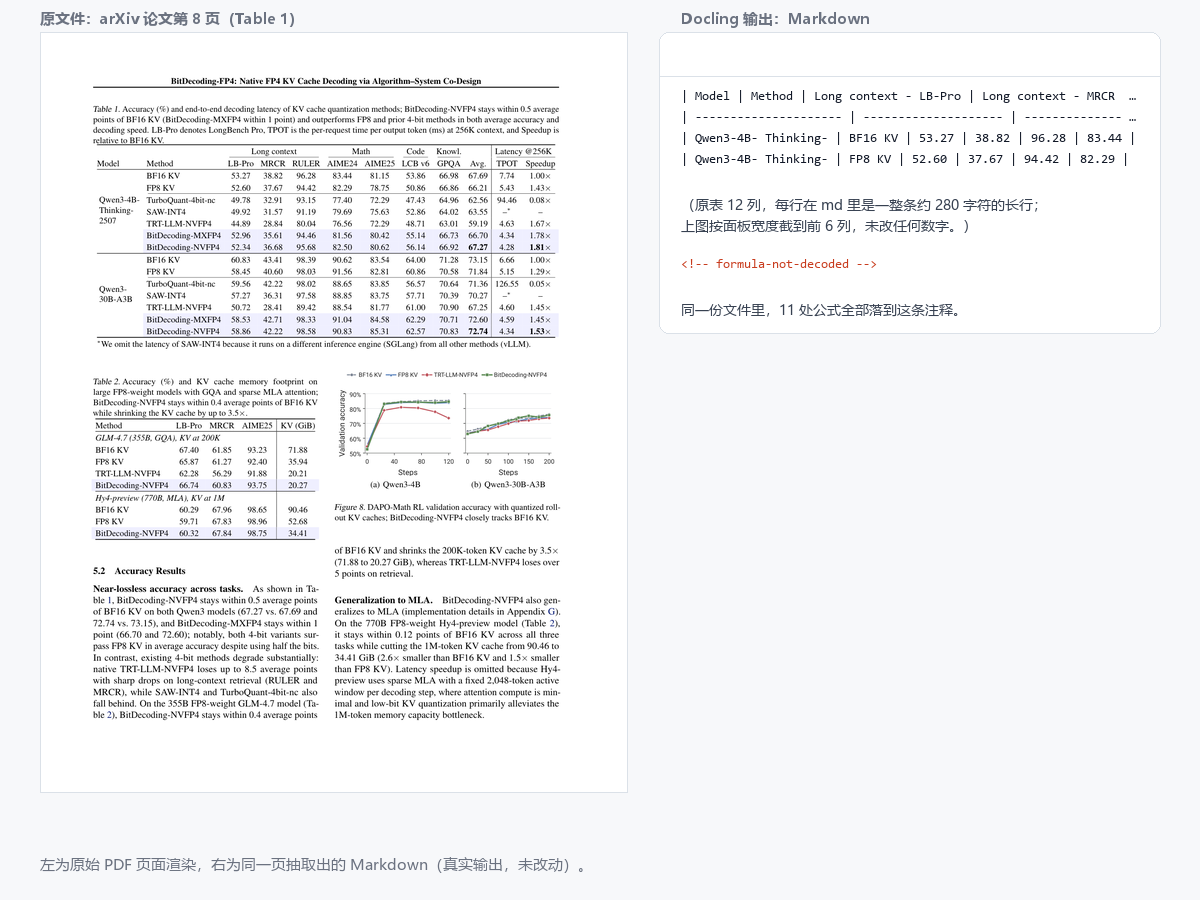
一份 17 页的量化论文,公式不可能少。转出来的 Markdown 里有 11 处 <!-- formula-not-decoded -->,就是一条注释,公式本体一个字都没有。
默认的 standard 管线不解公式,要开 --enrich-formula,或者直接上 VLM 管线 granite_docling,那需要额外的视觉模型和显存。在这台没显卡的机器上,公式这一块等于完全放弃。
顺手记一个细节:作者那一行邮箱前面有个符号,转完变成一个 �。整份文件只有这一个字符坏掉,但说明它不是无损的。
中文报告:字没认错,结构错得厉害
第二份是信通院今年七月的《云上人工智能可靠性建设指南》,78 页、1.59 MB、84 张图。
前 8 页用了 103 秒,正文第 10 到 15 页用了 74.11 秒,折下来 12.35 秒一页——比英文论文慢了一半,图更多、版式更密,代价就上来了。
中文本身没问题。6 页正文里 2,862 个汉字,没找到错字。错的是结构。
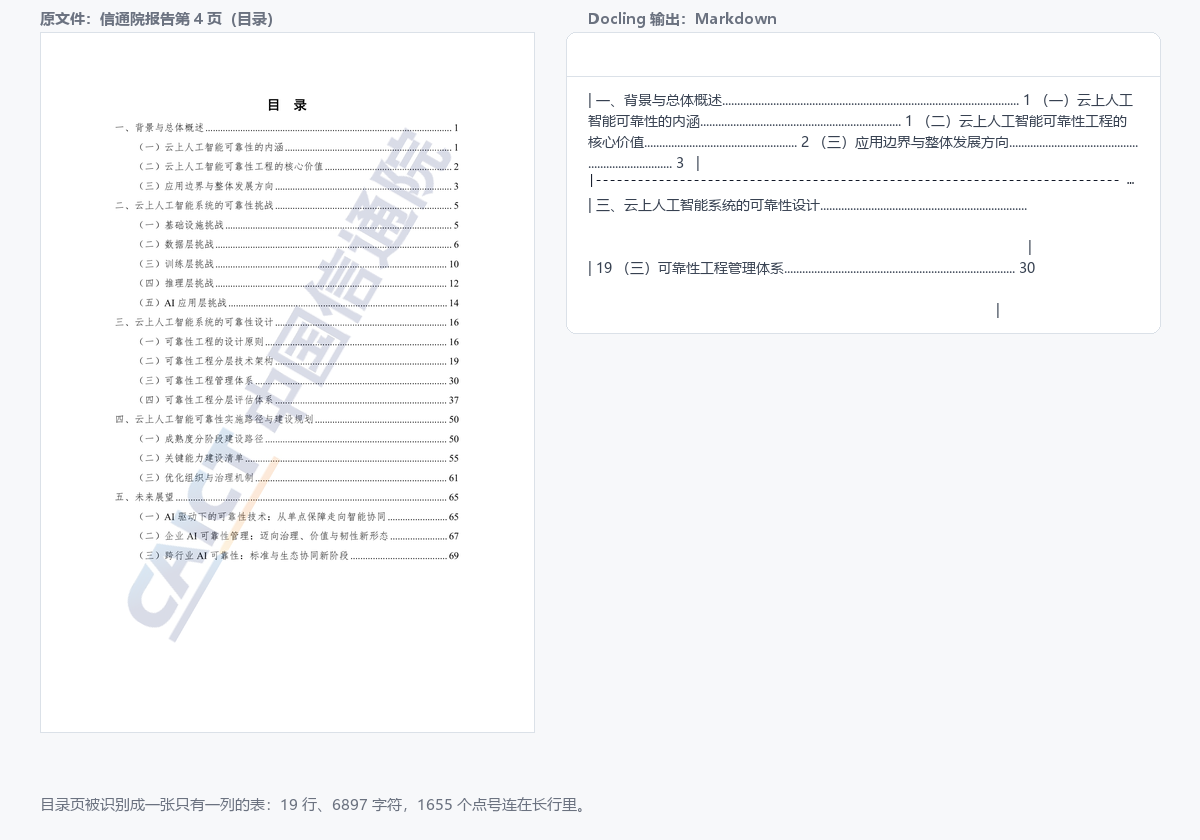
目录页被识别成一张只有一列的表:19 行、6,897 个字符,中间连着 1,655 个点号。任何按段落切分的用法,在这一页上都会得到一条几 KB 的无意义长串。
正文里「四是多样化的数据采集策略对数据隐私合规性构成严峻考验……」这种段首句,被当成了二级标题,「2.数据预处理阶段」也是。6 页正文出来 7 个标题,一大半是错认的。
什么时候值得用,什么时候别碰
值得用的场景很清楚:有文本层的电子 PDF、docx、html,要变成能进检索库的 Markdown。全本地、不上传、MIT 协议、没有额度限制——这一点在合同、财报、内部文档上是决定性的,很多云端解析服务根本不允许你把文件传上去。
不该指望它的地方也得说清楚。扫描件要另开 OCR 引擎,默认装的 rapidocr 质量是另一回事;带公式的论文基本报废,除非你有显卡跑 VLM;需要精确行归属的账表、合同条款表,光跨行单元格那一条就够返工。
替代方案按场景分。中文 PDF 多、机器有显卡,MinerU 更合适,它 11 月 4 日刚发 4.1.7,布局检测又调了一轮;只想要轻一点的 Markdown 输出,Marker 是 Apache-2.0,装起来比 Docling 省事;完全不想碰环境,就上云端按页付费的服务,代价是文件要出门。
你现在可以做的三件事
先拿三页试,别把整柜 PDF 一次丢进去。 --page-range 1-3 是最便宜的探路费,12.35 秒一页乘 78 页是十六分钟,试完再决定要不要跑全量。
境内先设 HF_ENDPOINT,再动第一次转换。 不设就是 ConnectTimeout,设完十秒下完,这颗坑踩一次就够了。
进库前把图片模式改成 referenced。 默认的 base64 会把 17 页的文档撑到 739 KB,纯文本只有 75 KB,差的那九成对检索没有任何帮助。
附:本文信息来源
一、一手信息
版本与命令
- Docling v2.149.0 发布说明(2026 年 11 月 8 日:CLI 重构、PDF 内嵌图抽取、MiniCPM-OCR 预设)
- PR #5214:命令重构,
--vlm-model不再被忽略、与 standard 管线冲突时直接报错 - PR #5143:新增可选的 PDF 内嵌图片抽取
- CLI 参考:convert / convert-remote / models / options 全部选项与默认值
- 安装文档:pip 与 uv 两种装法、各 OCR 引擎对应的 extra
项目与模型
- docling 仓库(MIT 协议,本次实测版本 2.149.0)
- PyPI 上的 docling 包
- 版面模型 docling-layout-heron(本次首次转换时下载,506 MB 里的主要部分)
- HuggingFace 镜像站(
HF_ENDPOINT指向这里才下得动模型)
本次实测的两份文件
- arXiv 2611.09825《BitDecoding-FP4: Native FP4 KV Cache Decoding via Algorithm–System Co-Design》(17 页,含 8 张表)
- 中国信通院《云上人工智能可靠性建设指南(2026年)》(78 页,2026 年 7 月)
二、可替代的开源方案
相关阅读
- 实测 Ollama 0.40.14:一个 launch 命令,把 18 个编码代理都接了过来
- 实测 agent-desktop 1.1.0:不截图,让 Agent 直接读 Windows 的控件树
- 本地跑大模型要多少显存:2026 年攒机的账要重算
本文为公开信息整理与实测记录,命令、版本号与默认参数以 Docling 官方文档当天状态为准。
原创声明:本文由 618A 情报站整理撰写,基于公开信息与实测记录,转载请注明出处并保留原文链接。