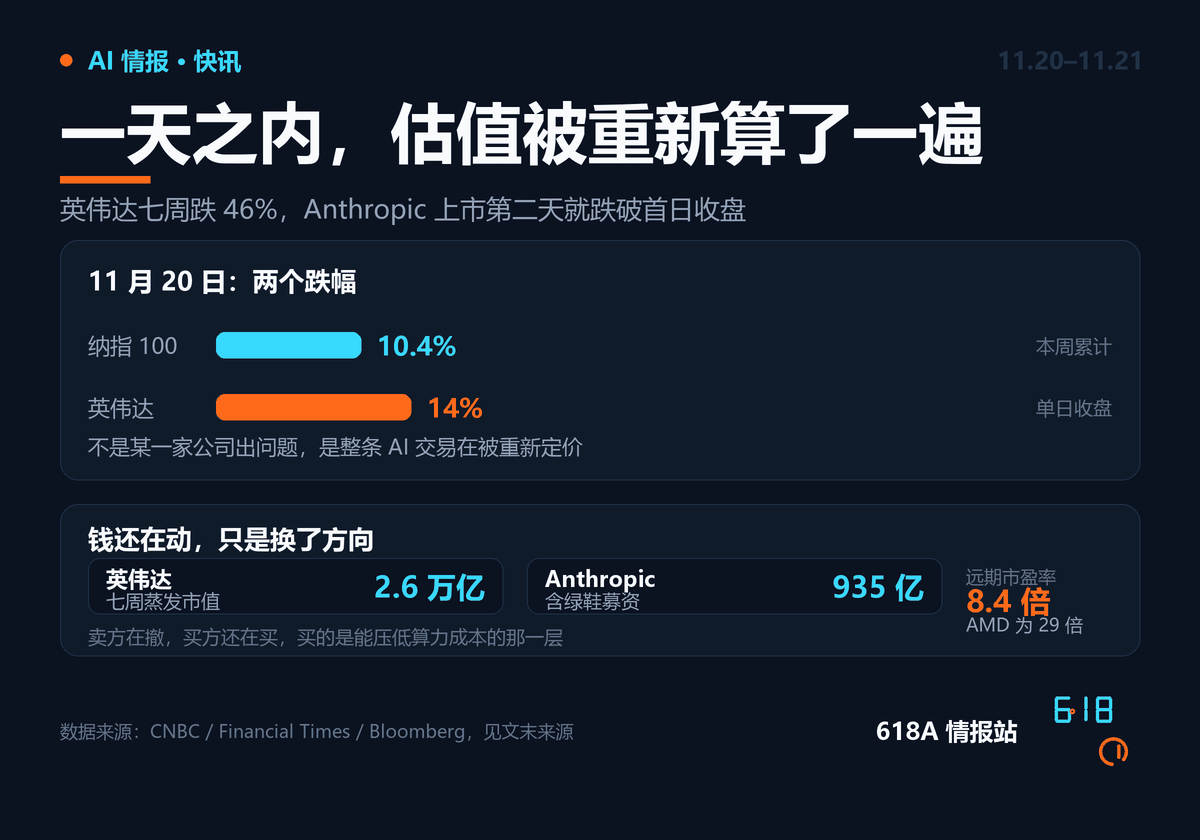
这两天的钱走的是反方向。11 月 20 日美股收盘,纳指跌 5.3%、标普 500 跌 3.7%,费城半导体指数一天掉 10.7%,标普比 10 月高点低了超过一成。同一天,亚马逊被曝接近以 75 亿美元买下一家做芯片软件的以色列公司;也是这一天,一位 Anthropic 的数学家宣布自己证明了黎曼猜想。
纳指一周跌掉一成,英伟达七周少了 2.6 万亿美元
11 月 20 日收盘,标普 500 报 6910.39 点,连跌七个交易日;纳指报 22617.73 点,年内收益转负;道指报 48147.33 点,跌破五万点。芯片股是震中,AMD 跌 13.3%,博通跌 12.1%。
英伟达这一天跌约 14%。按 CNBC 的口径,它已连跌七周,七周累计 46%,市值蒸发约 2.6 万亿美元,从全球第一掉到第四,远期市盈率只剩 8.4 倍——AMD 是 29 倍。
刚上市的 Anthropic 也没躲开,周五收 88.30 美元、跌 9.1%,盘中到过 115.10 美元,从高点回落约 23%,但仍站在 83 美元发行价上方。承销商周五行使超额配售权追加 122 亿美元,IPO 募资合计 935 亿美元。
SEC 开始查英伟达的账,770 亿美元的新加坡收入不见了
路透社同日报道,美国证监会正在调查英伟达的会计处理,焦点之一是它去年调整地区收入拆分时把新加坡拿掉了,约 770 亿美元的新加坡销售额因此在报表里失去位置。
这事要放在黄仁勋 11 月 12 日辞职的背景里看。董事会给的说法是「披露的个人行为不符合公司行为准则」,接任临时 CEO 的原 CFO 在财报会上只说了一句「we’ve got this」,并预测下一财年营收增长 75%。
口径调整本身未必违规,但叠在一个刚换掉创始人的季度里,市场先按「有问题」来定价。拿英伟达当核心持仓的,别只看下季指引,把地理收入拆分那张表自己重算一遍。
亚马逊掏 75 亿美元,买的是让 Trainium 更好用的那一层
11 月 21 日,金融时报援引消息人士称亚马逊接近以 75 亿美元收购以色列初创公司 Decart,谈判已进入深入阶段,最快下周敲定,也可能告吹。Decart 做的是让 AI 负载在不同芯片上跑得更高效,属于编译与运行时那一层。
亚马逊要的是让自研 Trainium 更好用:芯片能不能打早就不是峰值算力的事,而是同一份模型迁过来要改多少代码。英伟达的护城河一大半在 CUDA,AWS 补的正是这一层。这也解释了为什么卖方在撤、买方还在买。
一晚两道世纪难题:形式化做完了,读懂才刚开始
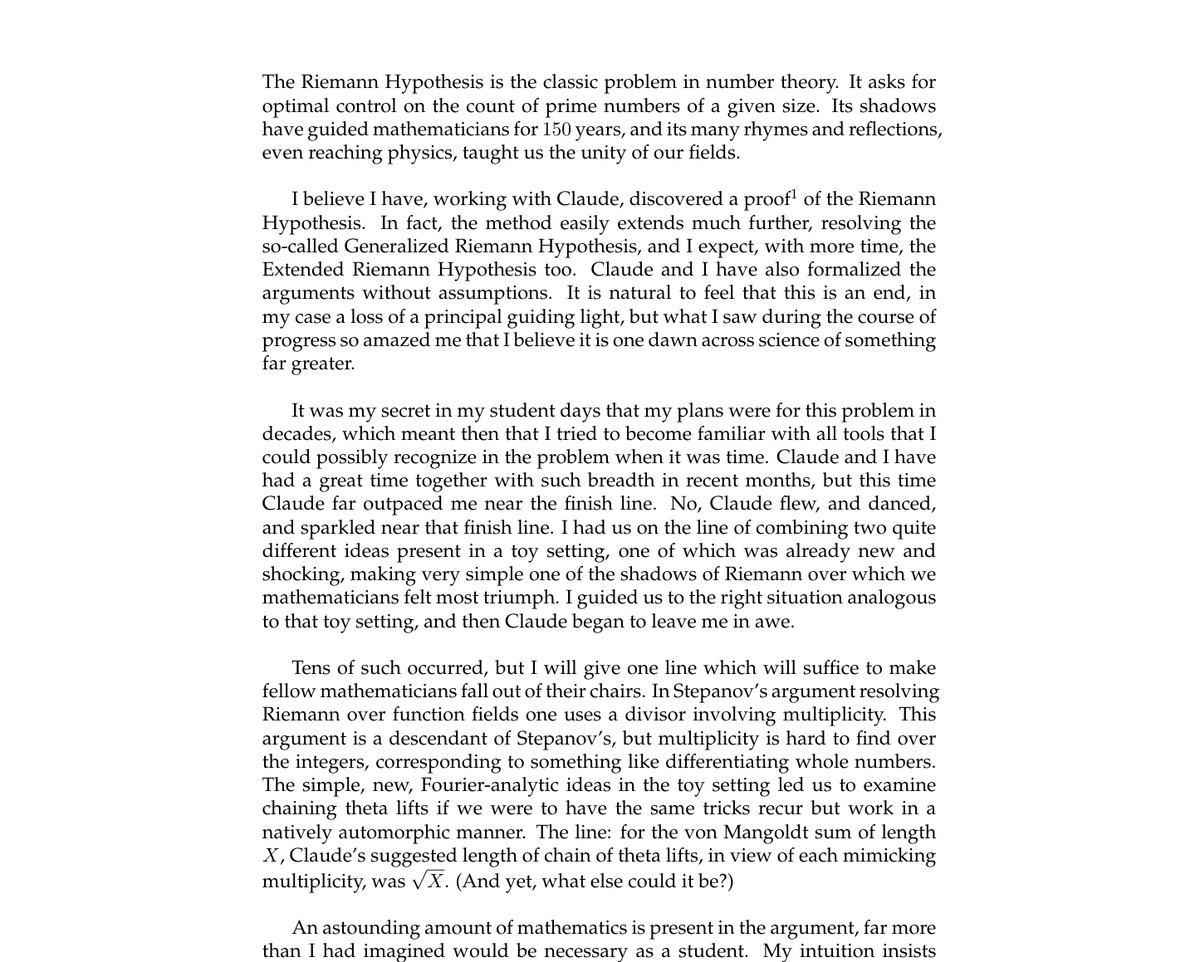
11 月 20 日,Anthropic 的数学家 Levent Alpöge 在自己网站发了四页声明,第一句是「我相信我与 Claude 一起发现了黎曼猜想的证明」。他声称范围还包括广义黎曼猜想,并称「Claude 与我在无假设的前提下完成了形式化」。
他自己给这份工作打了折:论证目前极长,形式化做完之后产出一份没人读得下去的巨型文档是常规操作。MIT 的 Andrew Sutherland 当天独立在 Lean 里编译通过,同时强调理解证明细节还有大量工作。同一天,人类数学家 Alessandro Masullo 也宣布了广义黎曼猜想的证明。
同一天上午,纽约大学的 Tristan Buckmaster 发布了与 Alpöge 合作的另一份结果:纳维-斯托克斯方程在原本该爆破的情形下确实爆破,堵上了 OpenAI 九月方案里那个精心调校外力的漏洞。代价是证书未公布、论文未打磨、未过同行评审。
做数论的,先把那份声明读完再决定信不信:形式化完成只说明机器能验的部分过关了,剩下的分歧全在「形式化的是不是那道题」。
26.4B 的开源模型,能塞进 32GB 内存的笔记本
Thinking Machines Lab 在 11 月 20 日放出开放权重的 Inkling 2 Mini:MoE 加循环 Transformer,总参数 26.4B、每 token 激活 3.4B,24 层分四块,中间两块每个 token 循环跑三次,整个模型约 20GB 内存。
官方跑法是 32GB 以上内存的 Mac 配 Ollama,量化版走 llama.cpp。SWE-bench Verified 79.2%、BrowseComp 79.0%,在总参数 100B 以下的开放权重模型里领先;Terminal Bench 2.1 是 71.6%,输给 Qwen3.8-27B 的 73.0%。弱点官方也写了:多轮对话偏弱,MultiChallenge 只有 50.0%。
循环带来的是算力等效而不是知识量,它适合当本地 agent 的执行层,不适合当百科。要在本地跑 agent 的,这周就拉 GGUF 到自己那台 32GB 机器上跑一遍手上的任务。
附:本文信息来源
一、一手信息
黎曼猜想声明
纳维-斯托克斯爆破证明
- Tristan Buckmaster、Levent Alpöge 的证明仓库
- Terence Tao《Unforced Euler singularity, unforced Navier-Stokes singularity, and the Generalized Riemann Hypothesis》
同期独立的人类证明
开源模型
二、媒体报道
11 月 20 日美股与英伟达
- 美联社《S&P 500 sinks 3.7% and the Nasdaq composite goes negative for the year》(NPR 转载)
- CNBC《Nvidia’s 7-week losing streak is longest since 2008 financial crisis》
- 金融时报《Nasdaq 100 falls 5.6% on Friday, worst run in more than six years》
Anthropic 上市与募资
英伟达会计调查
亚马逊收购 Decart
- 金融时报《Amazon is nearing a $7.5bn deal to buy AI start-up Decart》
- The Information《Amazon Nearing $7.5 Billion Purchase of Decart》
两道数学难题的报道
- 科学美国人《Anthropic Mathematician Claims to Prove Riemann Hypothesis》
- 科学美国人《AI Just Solved the Real Navier-Stokes Problem》
- 纽约时报《Anthropic Mathematician Claims to Have Solved Math’s Most Famous Problem》
- SiliconANGLE《Anthropic researcher claims to have proven Riemann hypothesis using Claude》
- Decrypt《Claude Claims Historic Math Breakthrough One Day After Anthropic IPO》
本文为公开信息整理与解读,数据以各厂商官方口径及上述报道为准。
原创声明:本文由 618A 情报站整理撰写,基于公开信息与实测记录,转载请注明出处并保留原文链接。