这三条消息落在同一个词上:价格。MiniMax 把「够用就好」那一档压到每百万 token 输入 1 元,亚马逊把迁到自家芯片压成改一行配置,腾讯干脆把教师的账单接了过去。
十月十九日晚上,Flash 这一档报出 1 块钱
MiniMax 正式发布 M3.1 Flash。此前匿名跑了两百多万亿 token、被叫作「太空兔」的 Space Bunny 就是它的早期版本。官方口径:线上推理快近 3 倍、使用成本降 70%。手段是更激进的稀疏注意力,日常输出 200 TPS 以上,中位数稳在 170 TPS 以上。
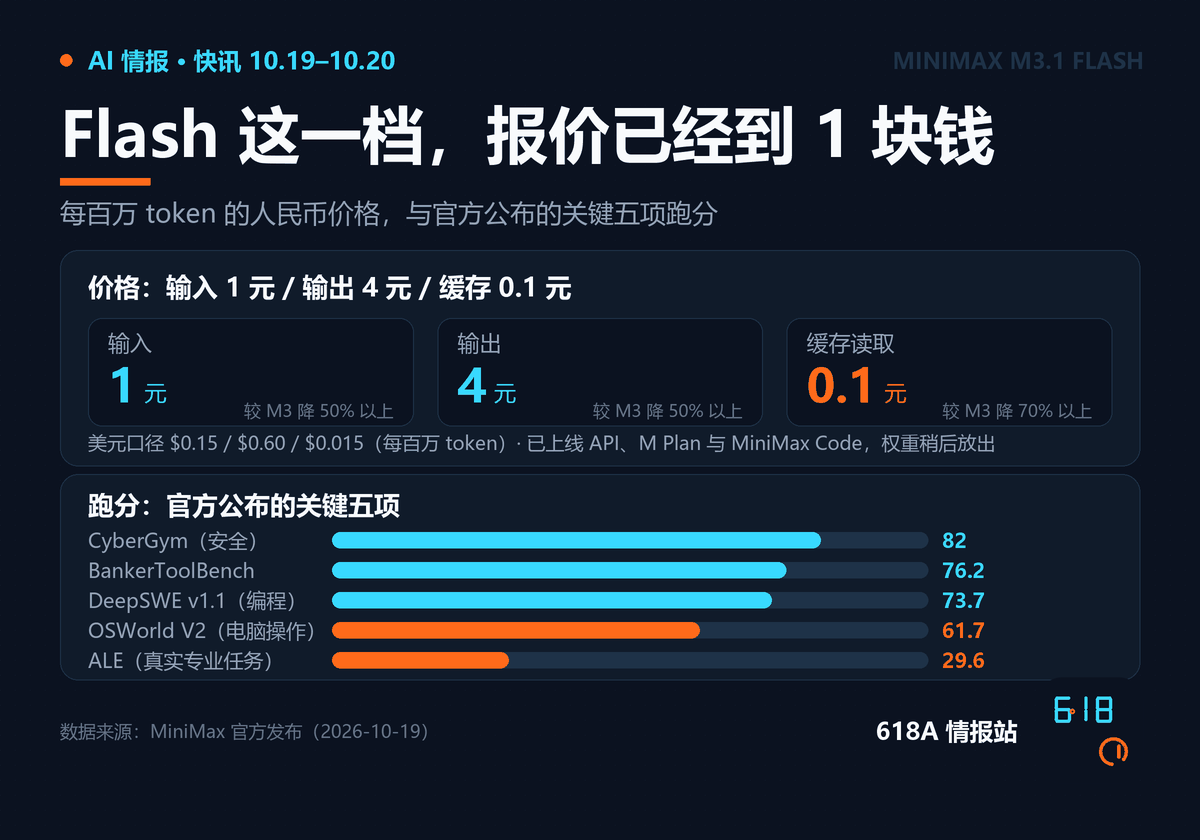
分数上,编程整条链路的 DeepSWE v1.1 是 73.7%;电脑操作的 OSWorld V2 拿 61.7 分、真实专业任务的 Agents’ Last Exam 拿 29.6 分,官方称这两项都是国产第一;网络安全 CyberGym 82%,金融场景的 BankerToolBench 76.2 分。复杂智能体那一栏官方只说「位居前列」,媒体引的榜单是 62.8 分,只有二手口径。
价格表是最硬的部分:每百万 token 输入 1 元、输出 4 元、缓存读取 0.1 元。比起上一代 M3,输入与输出单价都降了五成以上,缓存读取降了七成以上。已上线 API、M Plan 与 MiniMax Code,权重稍后放,更强的 Pro 也在路上。
放到时间线上才有意思。两天前 DeepSeek 刚发 V4.1-Flash-1017,MIT 权重、单任务成本一块三。两家前后脚把旗舰级的编程分数打到单任务一两块钱——同样分数的 Claude Opus 5,一个任务要七十多块。这不是某一家降价,是这一档的定价基准被换了一次。
亚马逊想让 PyTorch 代码改一行就搬到自家芯片上
当地时间 10 月 19 日,亚马逊公布开源工具 TorchNeuron;10 月 20 日在圣何塞的 PyTorch Conference 北美站进入公开测试。Apache 2.0 协议,仓库在 github.com/aws-neuron/torch-neuronx,支持 Trainium2 与 Trainium3。
它的做法不是重写框架,而是把自己挂成 PyTorch 的官方设备后端,接 PrivateUse1 扩展点与 torch.accelerator 接口。于是 torch.nn、torch.distributed、torch.profiler 照旧能用,搬家只改一处 .to('neuron')。演示里同一份训练脚本分别跑在常规芯片和 Trainium 上,唯一差别是指定芯片的参数,两边学到的内容与速度一致。
首版的缺口也明说:不支持动态输入形状——这恰恰是线上推理最常见的情形;约两万两千个 PyTorch 测试被跳过。倒是有第三方实据:Hugging Face 说最常用的 100 个文本生成架构里 89% 开箱可用,此前的 Optimum Neuron 是 46%;语音公司 Deepgram 自报每美元处理的音频秒数比 GPU 基线多约六成,这是客户自己测的。
英伟达的护城河不只是硬件,是 CUDA 那套让人懒得搬家的工具链,TorchNeuron 动的就是「懒得搬」的价钱。亚马逊自研芯片年化收入已过 250 亿美元,它要的不是性能反超,是让开发者比价时真能换一家。
同一天下午,腾讯把教师的 AI 账单接了过去
10 月 19 日,WorkBuddy 教育公益版在深圳福田发布,同步推出教师积分普惠计划:开通账号的教师连续 12 个月、每月 2000 积分,每月 1 日自动补满,用完还能用免费模型(混元 3 目前不限量免费)。不限地区与学段,小学到高校都能申。
首发落地在福田:全区约 110 所学校、近 1.3 万名教师全部配备,每人一本「AI 积分存折」。产品侧把教学设计、家校共育、学生成长、专业成长四类场景做成现成入口,创意教学、剧本课堂、课件制作也在内,另联合北大、北师大内置 209 位教育专家。教师不用琢磨提示词,说清教学目标和班级情况就行。
有张时间表要看清:2026 年 10 到 12 月是试点期,2000 积分所有模型通用;之后混元 4 单独 1600 积分、其他模型 400 积分,混元 3 仍不限量。申领走「腾讯 SSV」或「WorkBuddy」公众号,审核通过 3 个工作日内开通。
接下来两周,三家旗舰都在路上
The Information 在 10 月 19 日报道,Anthropic 在准备一款推理与直觉判断都超过现有商用产品的新模型,能从有限指令推断出没说明的目标——试用者的例子:让它修一个 bug,它会顺着找出一整类底层问题,再问要不要一起修。同篇提到谷歌在做 Gemini 4 Carbon,OpenAI 几周内推 Terra 系列,定价压在 GPT-6.1 Sol 之下。三条都未官宣,名字和日期别当定论。
这两天你可以做什么
换模型重跑一遍。 跑批量代码修复、agent 长任务的,拿 M3.1 Flash 跑同一批样本比成本。
别急着迁 Trainium。 TorchNeuron 还是 beta,动态 shape 不支持,生产先别搬;想试就拿研究脚本试。
教师先把账号申了。 12 个月、每月 2000 积分按月补,试点期口径最宽。
附:本文信息来源
一、一手信息
MiniMax M3.1 Flash(10 月 19 日)
- MiniMax 官方博客:MiniMax M3.1 Flash: Redefining Agent Performance and Cost(Space Bunny 的来历、五项跑分、200+ TPS 与中位 170+ TPS、美元价格表、API 与 M Plan 上线范围、权重稍后放出)
亚马逊 TorchNeuron(10 月 19 日公布 / 10 月 20 日公测)
- Amazon 官方新闻:Amazon opens its AWS Trainium AI chips to every PyTorch developer, no rewrite needed(85% 开发者用 PyTorch、改一行配置、同日训练对照演示、早期客户名单、向 PyTorch 上游提交硬件中立化改动、250 亿美元年化收入)
- GitHub 仓库:aws-neuron/torch-neuronx(Apache 2.0、支持 Trainium2 与 Trainium3)
WorkBuddy 教育公益版(10 月 19 日)
- WorkBuddy 官方公众号:WorkBuddy 教育公益版上线,老师每月可领 2000 积分(积分规则、试点期与试点后的额度差异、支持模型清单、四类教学入口、申领与开通流程)
二、媒体报道
MiniMax 新模型
- 澎湃新闻:MiniMax M3.1 Flash上线,性能全面加强,速度提升3倍,价格降低70%(人民币价格 1 元 / 4 元 / 0.1 元、与 M3 的降幅对比、Pro 版本预告)
- 界面新闻(腾讯新闻):MiniMax发布新一代Flash模型M3.1 Flash(发布时间 10 月 19 日晚、稀疏注意力架构)
- 新智元(今日头条):DeepSeek第一,MiniMax第二!国产Flash双子星杀疯了(Automation-Bench 62.8 分、与 Claude Opus 5 的单任务成本对比)
TorchNeuron
- 财联社(今日头条):剑指英伟达CUDA护城河:亚马逊推出开源工具TorchNeuron(10 月 19 日宣布、10 月 20 日 PyTorch 大会开源、30 余家早期客户、Annapurna Labs 的表态)
- 第一财经(网易):亚马逊的芯片棋局:TorchNeuron开源,聚焦生态解绑与算力话语权(Trainium 与 Graviton 的产品线、微软 Maia 的对照、250 亿美元年化收入)
- IT之家(腾讯新闻):挑战英伟达 CUDA,亚马逊推出开源工具 TorchNeuron(同脚本双芯片跑的对照结果、PyTorch 上游硬件中立化的合作方式)
- 钛媒体:亚马逊向英伟达开出最猛一枪:TorchNeuron 能否击穿 CUDA 护城河(PrivateUse1 与 torch.accelerator 的实现路径、Apache 2.0 与公测时间、eager 与 torch.compile 两种模式)
WorkBuddy 教育公益版
- 央广网:让AI先走到教师身边:WorkBuddy教育公益版正式发布 为全国教师提供12个月积分支持(福田 110 所学校与 1.3 万名教师、AI 积分存折、209 位教育专家的来源)
- 光明网:让AI先走到教师身边 WorkBuddy教育公益版发布(不限地区与学段、以校或区域为单位统一申领的办法)
- 中国新闻网广东频道:WorkBuddy教育公益版发布 面向全国教师提供12个月积分支持(福田教研院将以官方名义把教师经验转化为可调用的教育专家)
三家旗舰的动向
- 英为财情:Anthropic、谷歌与OpenAI竞相推出新一代AI模型(The Information 报道的转述:意图推断能力、Gemini 4 Carbon、Terra 系列的定价方向)
- 机器之心(网易):Claude要会「读心」了?Anthropic神秘新模型曝光(试用者描述的能力边界、型号猜测尚无官方确认)
三、其他
- PyTorch Conference North America 2026 议程(TorchNeuron 公测的场合)
- Hugging Face 关于 Trainium 原生支持的说明(89% 开箱可用率的出处)
- 亚马逊 Annapurna Labs 关于 TorchNeuron 技术细节的博客
本文为公开信息整理与解读,数据以各厂商官方口径为准。
相关阅读
原创声明:本文由 618A 情报站整理撰写,基于公开信息与实测记录,转载请注明出处并保留原文链接。