免费额度这件事的麻烦,从来不在「哪家有」,而在「哪家还有」。这两年中文互联网上的免费大模型 API 清单,很大一部分是同一份内容被反复复制出来的,复制得越久,离官方页面越远。今天这一篇不讲新消息,讲的是把几张流传最广的旧表逐条拉回官方页面核对之后,对不上的三个地方——其中一个入口已经关闭了整整两个月,一个数字从第一天起就对应错了模型。
最后核对:2026-10-10
GitHub Models 在 7 月 30 日就已全面下线,而不少清单还把它排在第一位
GitHub 的官方文档现在只剩一句话:As of July 30, 2026, GitHub Models has been fully retired。也就是说,从 2026 年 7 月 30 日起,GitHub Models 全面退役,playground、模型目录、推理 API,以及自带密钥(BYOK)都不再向任何用户开放。文档底下没有更多解释,只留了一条替代路径——要用 AI 模型,去 Azure AI Foundry。
这条消息值得单独拎出来讲,是因为 GitHub Models 恰好是那些旧清单里最显眼的一个:不用绑卡,一个 GitHub 账号就能调上百个模型,其中还包括当时只能付费才能碰到的闭源模型。对想零成本试一遍各家模型的人来说,它长期排在第一位。现在这个入口不存在了,照着清单去配的人会卡在第一步——找不到这个服务,也没有任何报错提示告诉他为什么。
有个容易混淆的地方需要点明:GitHub Models 和 GitHub Copilot 一直是两套并行的东西。退役的是前者,不影响 Copilot 订阅里自带的模型额度;但 Copilot 本身是付费服务,它从来不属于免费额度。
Groq 那个「每天一万四千次」,从来不属于能对话的模型
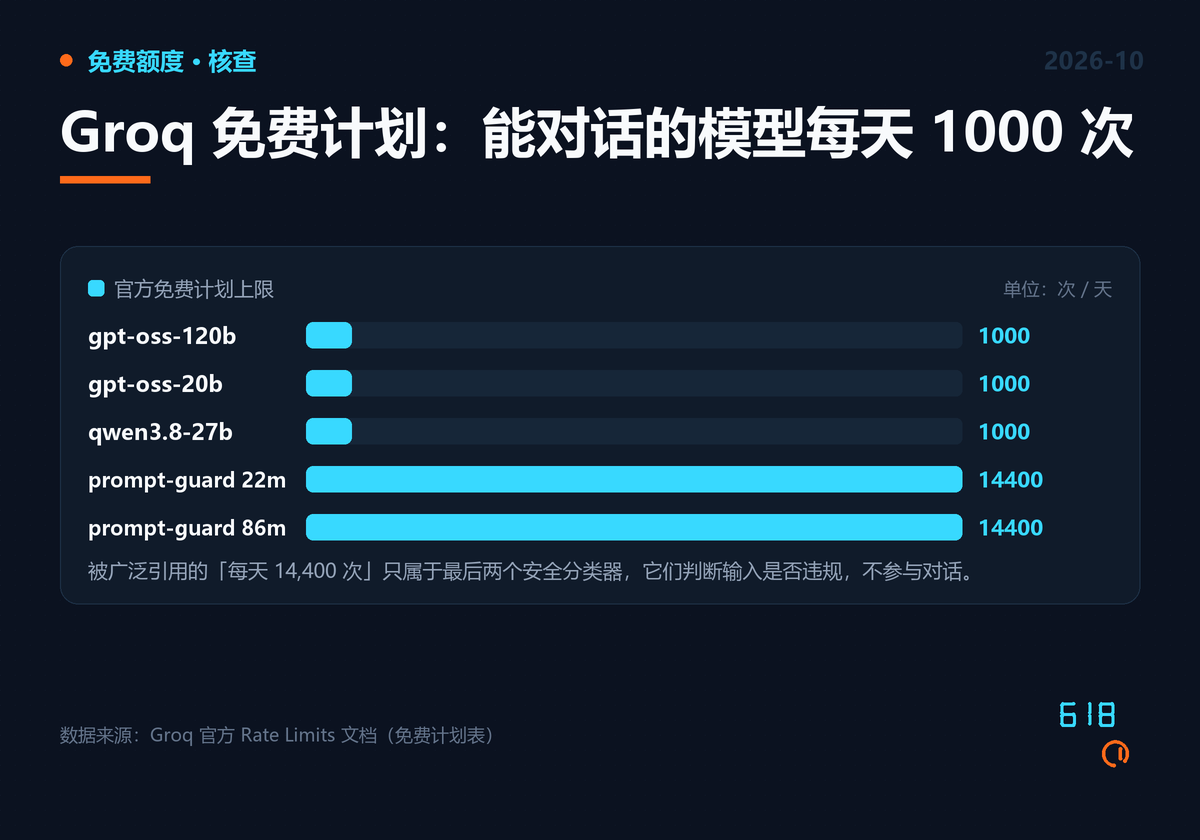
Groq 是免费 API 清单里的常客,理由很实在:它跑在自研的 LPU 芯片上,出字速度快,注册不绑卡。流传最广的一句话是「Groq 免费层每天 14,400 次请求」。这个数字本身没有编错,错的是它对应谁。
翻它的官方限流页,免费计划里能被调用来对话的模型只有三个:openai/gpt-oss-120b、openai/gpt-oss-20b、qwen/qwen3.8-27b。三者的额度完全一致——每分钟 30 次请求、每天 1,000 次请求、每分钟 8,000 Token、每天 200,000 Token。而 14,400 这个数只挂在两个名字很长的模型下面:llama-prompt-guard-2-22m 和 llama-prompt-guard-2-86m。
这两个是安全分类器,职责是判断一段输入有没有违规,它不跟你对话。所以那句流传甚广的「每天 14,400 次」,是一句被传丢了宾语的话。
这则误传还有一处很具体的来源。同一个官方页面上,紧挨着限流表的响应头小节,给出的示例值恰好就是 x-ratelimit-limit-requests: 14400。也就是说,14,400 在这一页出现了两次,两次都不属于能对话的模型——把响应头示例当成自己账号的额度,是一次很容易发生的误读。
同一页上还藏着一条更实用的信息:被缓存的 Token 不占用限流额度。把固定不变的长提示词放到请求最前面——比如系统指令、工具定义——让它命中缓存,就能实打实省下每分钟那 8,000 Token 的配额。
Llama 从 Groq 免费层整体消失,每分钟 8K 是另一道隐形天花板
顺着同一张表往下看,会发现另一件旧教程从来没提过的事:llama-3.3-70b-versatile 和 llama-3.1-8b-instant 已经不在免费计划里了。这两个模型名几乎是所有 Groq 教程的默认开头,现在拿自助注册的密钥去调,会直接报模型不存在或无权访问——它们已经转成需要联系销售的企业版。想继续用同一档位的能力,把模型名换成 openai/gpt-oss-120b 就行。
比模型下架更值得留意的,是每分钟 8,000 Token 这道坎。它和「每天 200,000 Token」是两个并列的闸门,任何一道先触发都会限流。一次 8,000 Token 的提示词——大概是几千字中文再加几轮工具调用的返回——就能把整分钟的额度吃干净。日常做对话、翻译、摘要完全够用;但如果拿它去跑一个每轮都要重发大段上下文的编码智能体,就会变成每分钟只能往前挪一步。这不是额度不够,是节奏不对,两条路最后的花费差得很远。
Cloudflare 送的额度和你能用的模型,是两件事
Cloudflare Workers AI 的规则写在 Neurons 这个单位上:每个账号每天 10,000 Neurons,免费计划和付费计划都给,每天零点(UTC)重置,超出之后直接报错,不会悄悄转成扣费。官方定价页同时标了单价,1,000 Neurons 收 0.011 美元。
它的问题不在额度小,而在额度能买到什么。定价页上用一行小字圈出了一批例外:moonshotai/kimi-k2.6、kimi-k2.7-code、zai-org/glm-5.2、glm-5.3、glm-5.3-flash,以及 deepseek-v4-flash-0731、deepseek-v4-pro-0813,这七个模型必须绑定付费方式才能调用。
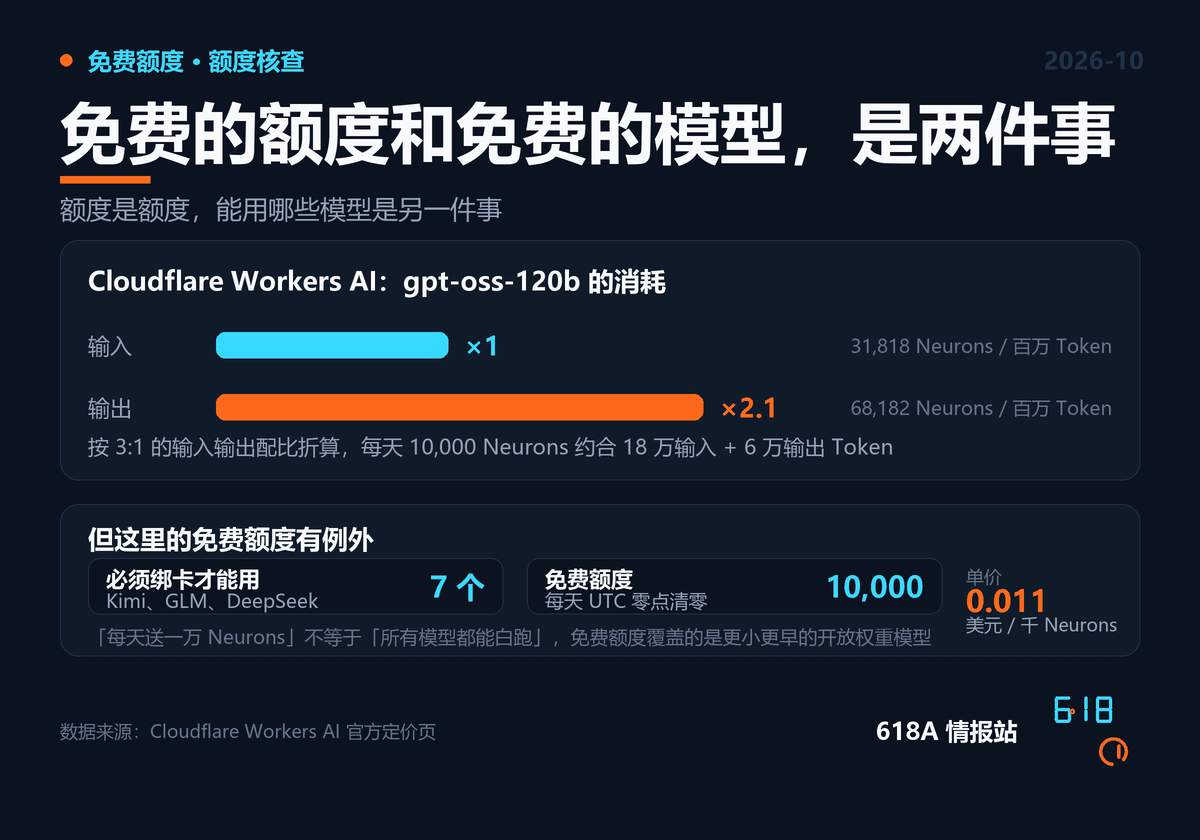
换个说法:「每天送一万 Neurons」不等于「所有模型都能白跑」。免费额度真正覆盖得住的,还是那些尺寸更小、发布更早的开放权重模型。这条规律在其他几家平台同样成立,只是 Cloudflare 把它写在了明处,值得当成通用常识记下来。
OpenRouter 每天五十次,多开账号没有用,也没有优惠码这回事
OpenRouter 是另一条被广泛推荐的路径:不绑卡、注册即用、一个密钥打通几十家模型。它的免费规则也是几家里面写得最清楚的——只用带 :free 后缀的模型时,每分钟 20 次、每天 50 次;等累计充值满 10 美元,每天的额度从 50 次提到 1,000 次。注意这里说的是累计,充过一次就长期有效,不需要每月续。
官方在同一页堵死了两个常见的绕路想法。第一,多开账号、多建密钥都不会放宽限制,因为限流按平台全局治理,不按账号计算。第二,翻遍它的计费与限流文档,找不到任何促销码或优惠券机制,网上那些标着「OpenRouter 优惠码」的页面没有一个能对上官方规则。
国内目前最实在的,还是智谱和阿里云百炼
把国外这一圈走完,结论反而有点反直觉:对中文场景来说,现在最稳的免费额度在国内。
智谱的免费档铺得最开。它官方模型概览里明确标成免费文本模型的有 GLM-4.7-Flash、GLM-4.5-Flash 和 GLM-4-Flash-250414,其中 GLM-4.7-Flash 的上下文窗口到 200K;视觉理解有 GLM-4.6V-Flash、GLM-4.1V-Thinking-Flash 和 GLM-4V-Flash;图像生成有 CogView-3-Flash,视频生成有 CogVideoX-Flash。文本、看图、画图、出视频四类都有免费模型,这个组合在国内几家里是独一份。
阿里云百炼比的是总量。开通平台就自动到账,不需要手动领取,每个模型送 100 万 Token,累计超过 7,000 万 Token,有效期 90 天,覆盖 deepseek-v4.1-flash 这些主力模型。它最大的认知误区是「要实名才能领」—— 官方页面写得很清楚,无需实名认证即可获取和使用免费额度,只有额度用完、想转按量付费接着用时才需要补齐实名。所以新用户上来就能用,不用先卡在实名那一步。另外,OAuth 认证还有一套独立的免费额度,每天 2,000 次调用,和 API Key 的 Token 额度互不混算,控制台里也查不到 OAuth 的消耗。用的时候还有三条坑:免费额度只在华北2(北京)地域生效,换地域就没有;不同模型、甚至同一模型的不同快照版本(比如 qwen-max 和 qwen-max-2026-05-17)额度各自独立、用尽不会自动切换,要自己改 model 参数;未实名账号额度用完就直接调不动,已实名才会自动转按量。90 天到期或额度用尽后转按量计费,开通后第一件事还是去控制台打开「免费额度用完即停」,并且别拿它承接生产环境。
硅基流动这类聚合平台走的是第三条路——不只是送额度,而是直接把一部分垂类模型的输入输出价标成免费,集中在文档解析、向量、语音、图像这些方向上,一个密钥就能调。它的免费名单会变,之前已经有模型被移出免费档,所以隔一阵要回定价页看一眼。
还有几家长期免费入口,数字以官方为准
上面三家是当前最值得盯的,但国内免费额度并不止它们。下面几家长期挂着免费档,值得知道,只是数字由各平台按月调整,一律以厂商官方页面为准,别拿这段当凭据。百度千帆给新用户每个模型约 100 万 Token(约三个月有效),ERNIE-Speed 和 ERNIE-Lite 长期免费,领取需要实名;DeepSeek 的网页和 App 对话长期免费,开放平台新账号也有赠送额度,具体数额以注册页为准;火山方舟(豆包)注册实名后每天自动发放额度;月之暗面 Kimi 给新用户一笔赠送额度;腾讯元器新用户直送大额 Token、还带个人每月免费 API 次数。和前面逐条核对过官方限流页的几家不同,这一节是社区整理,价值在于「还有这些入口」,不在于精确数字。
两家模型规格最高,但附加条件最容易被忽略
如果目标是跑前沿尺寸的开源模型,免费选项里绕不开 NVIDIA 的 build.nvidia.com。那上面有一批标记为免费端点的模型,覆盖 GLM、Kimi、DeepSeek 的前沿尺寸,规格比大多数免费档高一档。
代价是三条。它已经不再使用早期的积分制,也不公开每个模型的限流数值,开发者论坛上的口径是没有官方提额途径,社区观测到的每分钟 40 次只能当参考值。它提供的 API 试用条款写明只能用于测试与评估、不得用于生产,这一条很少被转述。另外,在同一个开发工具里开多个任务会共用同一份每分钟额度,并行跑反而更容易撞限流。
Google 的 Gemini 免费层是另一个「规格很高但要看清条款」的例子。官方限流页给出的是一套判定口径,而不是一组承诺:限流同时按每分钟请求数、每分钟输入 Token、每天请求数三个维度判断,配额跟着云项目走而不是跟着密钥走,每天太平洋时间零点重置;原文里还明确写着给出的限流值不保证、实际容量会浮动,想看自己账号的真实值得去 AI Studio。
更需要留意的是数据条款。官方定价页把「用于改善我们的产品」列成了一个独立字段,免费方案下这一栏是「是」。这句对个人试验影响不大,但如果要把客户资料、内部文档、密钥这类内容送进去,要考虑的就不是省不省钱了。
按用途选,比按额度大小选靠谱
把这些摊平了看,选免费 API 的判断标准不是数字大小,而是你要做的事和额度单位对不对得上。
要中文对话、要国内直连,智谱的 GLM-4.7-Flash 最省事,永久免费、上下文够长、不用折腾网络。想试前沿尺寸的开源模型,去 build.nvidia.com,但只用于评估,别接到线上。写代码、接第三方客户端,OpenRouter 的 :free 模型覆盖面最广,前提是补齐那 10 美元,否则每天 50 次撑不了几轮。要低延迟实时响应,看 Groq,但先把提示词压进 8,000 Token 以内。批量跑分类、摘要、打标这类后台任务,Cloudflare 的 10,000 Neurons 好处是预算可预测,每天固定清零。要多模态——看图、画图、出视频——目前免费档里只有智谱一家四类齐全。
有两件事跟选哪家无关,但每次动手前都要过一遍。
现在还挂着旧教程里那串 Llama 模型名去调 Groq 的,今天就去换成 gpt-oss-120b。
习惯把内部资料往免费档丢的,先回去确认那家的数据条款是怎么写的。
免费额度这类数字是按月变的,今天能用的不等于下个月还在。这篇的价值不在具体数字,而在哪几家还活着,以及哪几个流传很广的数字从一开始就对应错了模型。
当前可用的免费额度一览
| 厂商 | 免费内容 | 官方限制 | 门槛 |
|---|---|---|---|
| 智谱 GLM | 文本 GLM-4.7-Flash(200K)、GLM-4.5-Flash、GLM-4-Flash-250414;视觉 GLM-4.6V-Flash 等三个;图像 CogView-3-Flash;视频 CogVideoX-Flash | 未公布公开限流 | 永久免费档,不绑卡 |
| 阿里云百炼 | 每个模型 100 万 Token,累计超 7,000 万 Token | 有效期 90 天 | 开通即到账,无需实名即可领取和使用免费额度 |
| 硅基流动 | 部分垂类模型输入输出免费(文档解析、向量、语音、Kolors 图像生成等) | 免费名单持续变动 | 注册即用,以定价页为准 |
| Groq | gpt-oss-120b、gpt-oss-20b、qwen3.8-27b;Whisper 语音转写 | 聊天模型 30 RPM / 1,000 RPD / 8K TPM / 200K TPD | 不绑卡,需手机验证 |
| OpenRouter | 20 多个带 :free 后缀的模型 | 20 RPM;未充值 50 RPD,累计充值满 10 信用点后 1,000 RPD | 不绑卡 |
| Cloudflare Workers AI | 全部模型共用每天 10,000 Neurons | UTC 零点重置,超出直接报错 | 不绑卡;但 Kimi k2.6 等 7 个模型需绑卡 |
| Google Gemini | Gemini 3.x Flash 系列,100 万 Token 上下文 | 按 RPM、输入 TPM、RPD 三维判定,官方不保证具体值 | 不绑卡 |
| NVIDIA NIM | 100 多个开放权重模型,含 GLM、Kimi、DeepSeek 的前沿尺寸 | 不公开 | 不绑卡;仅限测试评估,禁止用于生产 |
变更记录:谁在什么时候变了
| 服务 | 变化 | 依据 |
|---|---|---|
| GitHub Models | 2026-07-30 起全面退役,playground、模型目录、推理 API 与 BYOK 对所有用户关闭,替代路径是 Azure AI Foundry。 | GitHub 官方文档 |
| Groq 免费层 | llama-3.3-70b-versatile 与 llama-3.1-8b-instant 撤出免费计划,转为需联系销售的企业版;能对话的只剩 gpt-oss-120b、gpt-oss-20b 与 qwen3.8-27b 三个。 | Groq 官方限流页 |
| NVIDIA NIM | 停用早期的注册送积分制度,改为不公开的按模型限流,官方没有提额途径。 | 官方试用条款 |
| 阿里云百炼 | 修正:免费额度无需实名即可领取和使用(仅转按量才需实名);补 OAuth 独立免费额度(每日 2,000 次)及三条使用坑(仅华北2北京地域、模型快照版本额度不互通、未实名用完即停)。 | 阿里云百炼官方文档(2026-10-10 更新) |
| 硅基流动 | 免费模型名单持续变动,社区观察小模型永久免费已取消,仅剩部分垂类模型(文档解析、向量、语音、图像生成等)。 | 社区整理,以官方定价页为准 |
一、一手信息(厂商官方页面)
- GitHub Docs:GitHub Models(「As of July 30, 2026, GitHub Models has been fully retired」原文,以及指向 Azure AI Foundry 的替代路径)
- Groq Docs:Rate Limits(免费计划全模型限流表;三个可对话模型各 1,000 RPD;14,400 RPD 只属于 llama-prompt-guard-2 两个分类器;缓存 Token 不计入限流;Llama 3.3 70B 与 3.1 8B 已不在免费计划)
- OpenRouter Docs:Credit & Rate Limits(:free 模型 20 RPM,未充值 50 次/天,累计充值满 10 个信用点后 1,000 次/天;多开账号与多建密钥不放宽)
- Cloudflare Docs:Workers AI Pricing(每天 10,000 Neurons、UTC 零点重置、0.011 美元/千 Neurons,以及必须绑定付费方式的七个模型清单)
- Google AI for Developers:Gemini API Rate Limits(三维限流口径、按项目配额、太平洋时间零点重置、不保证实际值)
- Google AI for Developers:Gemini Developer API 定价(「用于改善我们的产品」字段,免费方案为「是」)
- 智谱 AI 开放文档:模型概览(标注为免费文本模型、免费视觉推理、免费视频生成、免费图像生成的完整清单)
- 阿里云百炼产品页 · 硅基流动模型列表 · NVIDIA NIM 模型目录
二、第三方整理(用于交叉印证,数字未在官方页面逐条复核)
- freellm.net:Free Groq API Key, Base URL & Rate Limits(把「14,400 RPD for most models」写给免费模型的典型页面,可作为误传源头之一)
- AgentDeals:NVIDIA NIM Free Tier 2026(NVIDIA 停用积分制、限流不公开、试用条款限制生产使用的记录)
- Decode the Future:Best Free LLM APIs in 2026(各家免费额度按月度 Token 折算的横向对照,含 GitHub Models 退役提示)
本文为公开信息整理与解读,数据以各厂商官方口径为准。
相关阅读
原创声明:本文由 618A 情报站整理撰写,基于公开信息与实测记录,转载请注明出处并保留原文链接。